






Crawl dữ liệu website với n8n là dùng workflow tự động gửi yêu cầu tới trang web (qua node HTTP Request hoặc một API crawl như Dumpling AI), lấy nội dung, rồi chuyển cho các node khác xử lý. Ví dụ dưới đây đọc danh sách URL từ Google Sheets, crawl, nhờ AI Agent tóm tắt và gửi bản tin qua Gmail.
Bạn không cần viết một công cụ crawl riêng: n8n có sẵn node HTTP Request, node HTML để tách dữ liệu và node AI Agent trong n8n để tóm tắt. Trước khi crawl, hãy đọc mục pháp lý ở cuối hướng dẫn.
Web crawling là gì?
Web crawling là quá trình tự động truy cập vào các trang web, thu thập và trích xuất dữ liệu từ nội dung hiển thị trên website đó. Công cụ hoặc chương trình thực hiện việc này được gọi là crawler hoặc web spider.
Crawler hoạt động bằng cách gửi yêu cầu đến một URL, đọc nội dung HTML trả về, sau đó phân tích và lấy ra các thông tin cần thiết như tiêu đề bài viết, giá sản phẩm, hình ảnh, liên kết,… Sau khi thu thập xong, dữ liệu có thể được lưu trữ hoặc xử lý tùy vào mục đích sử dụng.
Các ứng dụng phổ biến của việc crawl dữ liệu
Việc crawl dữ liệu website có thể ứng dụng trong nhiều lĩnh vực và mục tiêu khác nhau:
- Theo dõi giá sản phẩm: Thu thập giá công khai từ các trang thương mại điện tử để so sánh, làm công cụ cảnh báo khi giá giảm.
- Tổng hợp tin tức: Lấy tiêu đề và đoạn tóm tắt từ các trang báo điện tử để cập nhật nhanh hoặc phân tích xu hướng, kèm link nguồn.
- Thu thập dữ liệu tuyển dụng: Lấy danh sách việc làm từ các trang tuyển dụng cho phép, lọc theo ngành, địa điểm, mức lương.
- Phân tích đối thủ cạnh tranh: Theo dõi các thay đổi sản phẩm, dịch vụ, chiến lược content hoặc SEO của đối thủ.
- Nghiên cứu thị trường: Tổng hợp đánh giá sản phẩm ở dạng thống kê, không lưu thông tin cá nhân của người viết đánh giá.
Vì sao nên dùng n8n để crawl thay vì code tay?
Thông thường, để crawl dữ liệu, bạn cần biết lập trình với các ngôn ngữ như Python, sử dụng thư viện như BeautifulSoup, Scrapy… Đó là rào cản lớn với những ai không có nền tảng kỹ thuật.
n8n mang lại một giải pháp đơn giản hơn rất nhiều:
- Ít code: Bạn chủ yếu kéo-thả các node có sẵn như HTTP Request, HTML, Split Out.
- Giao diện trực quan: Thiết kế luồng công việc dễ nhìn, dễ hiểu, phù hợp cho cả người mới bắt đầu.
- Tự động hóa mở rộng: Sau khi crawl xong, bạn có thể kết nối dữ liệu với Google Sheets, gửi email, đẩy lên API khác hoặc lưu trữ ở nơi khác.
- Dễ bảo trì và chỉnh sửa: Nếu muốn thay đổi nguồn crawl, cấu trúc dữ liệu hay điểm lưu trữ, bạn chỉ cần điều chỉnh lại vài node trong workflow.
Trang tĩnh chỉ cần node HTTP Request. Trang cần chạy JavaScript mới hiện nội dung thì dùng Puppeteer với n8n; muốn dùng crawler dựng sẵn trên cloud thì xem tích hợp Apify vào n8n hoặc Scraper API với n8n.
Hướng dẫn cách crawl dữ liệu website với n8n
Workflow mẫu gồm 9 node: Manual Trigger → Google Sheets → HTTP Request (Dumpling AI) → Split Out → Edit Fields → Code → AI Agent → Edit Fields → Gmail.
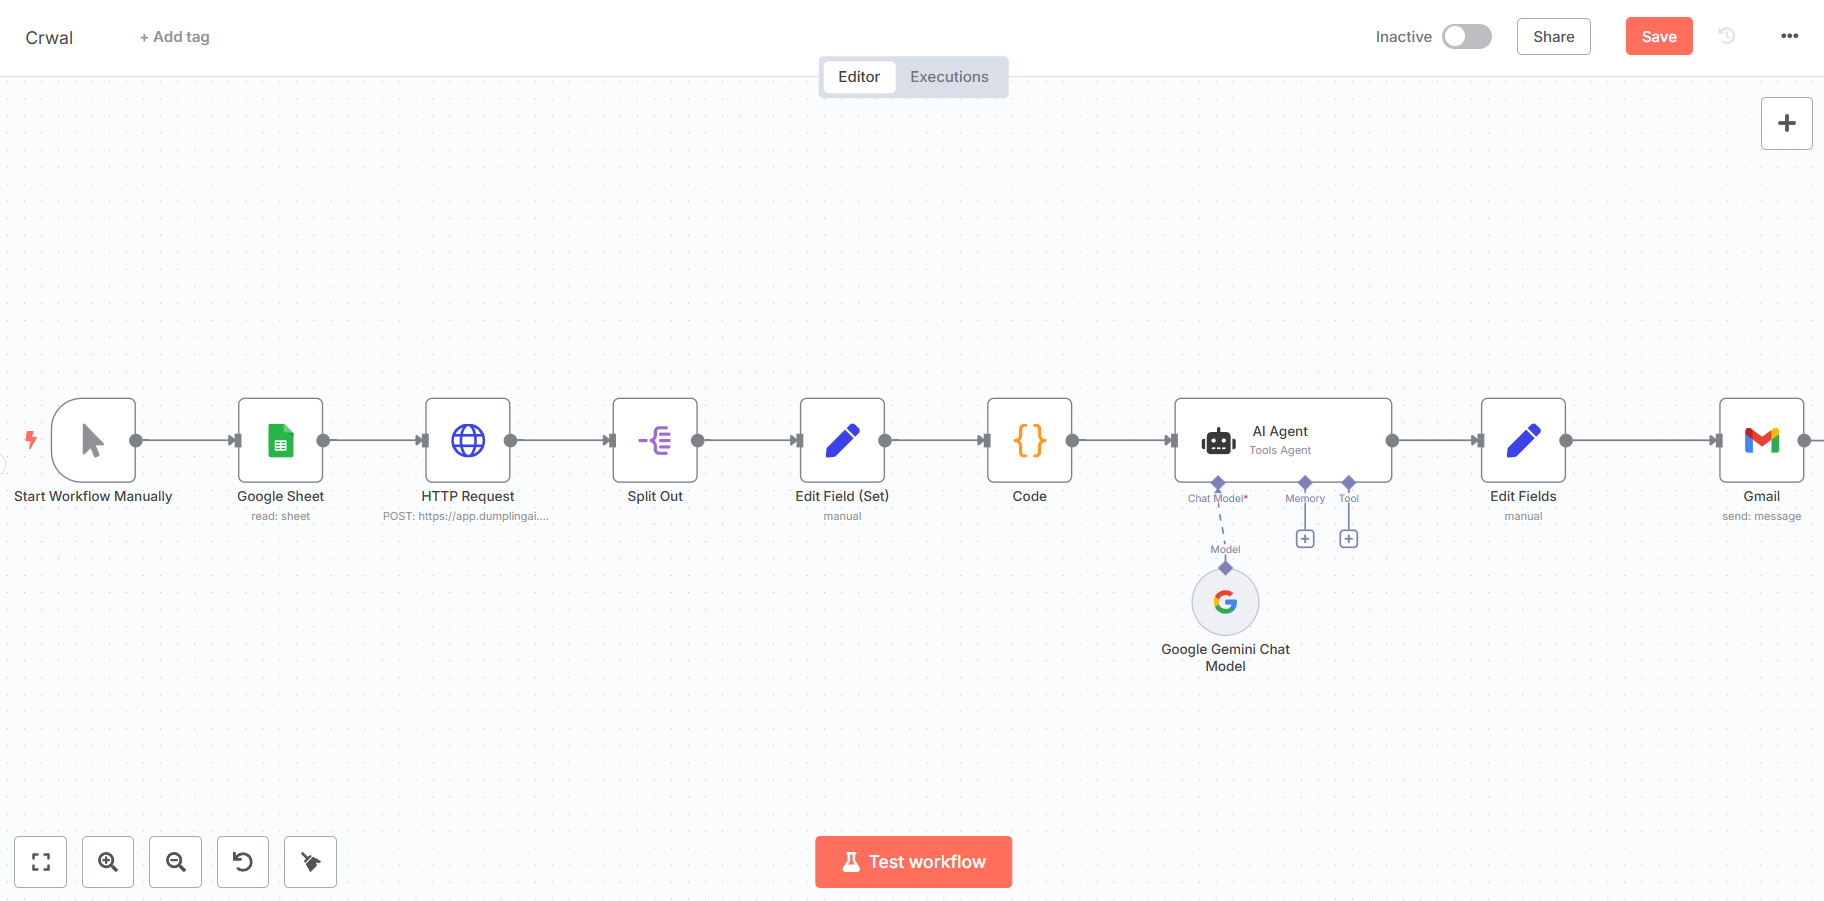
Bước 1: Thêm node Manually Trigger
Node này là điểm khởi đầu của workflow, cho phép bạn kích hoạt toàn bộ quá trình một cách thủ công. Khi chạy ổn, có thể đổi sang Schedule Trigger để crawl định kỳ.
Bước 2: Thêm node Google Sheet
Node Google Sheet được sử dụng để đọc danh sách các URL từ một bảng tính Google Sheet. Điều này giúp bạn dễ dàng quản lý các trang web cần crawl mà không cần chỉnh sửa workflow mỗi lần.
Trước tiên, bạn cần chuẩn bị một bảng Google Sheets gồm một cột đặt tên là websites (chữ thường, khớp biểu thức ở Bước 3) chứa URL các website cần crawl. Ví dụ:

Sau đó, quay lại n8n và cấu hình như sau:
- Credential to connect with: Bạn cần thiết lập credential Google Sheets để n8n có thể truy cập vào bảng tính của bạn. Tham khảo bài viết: Cách xác thực Credential cho Google trên n8n
- Resource: Chọn Sheet Within Document.
- Operation: Chọn Get Row(s) để lấy tất cả các hàng từ bảng tính.
- Document: Chọn By URL và nhập URL của Google Sheet của bạn vào trường https://docs.google.com/spreadsheets/….
- Sheet: Chọn tên trang tính mà bạn muốn đọc dữ liệu, ví dụ: Trang tính1.
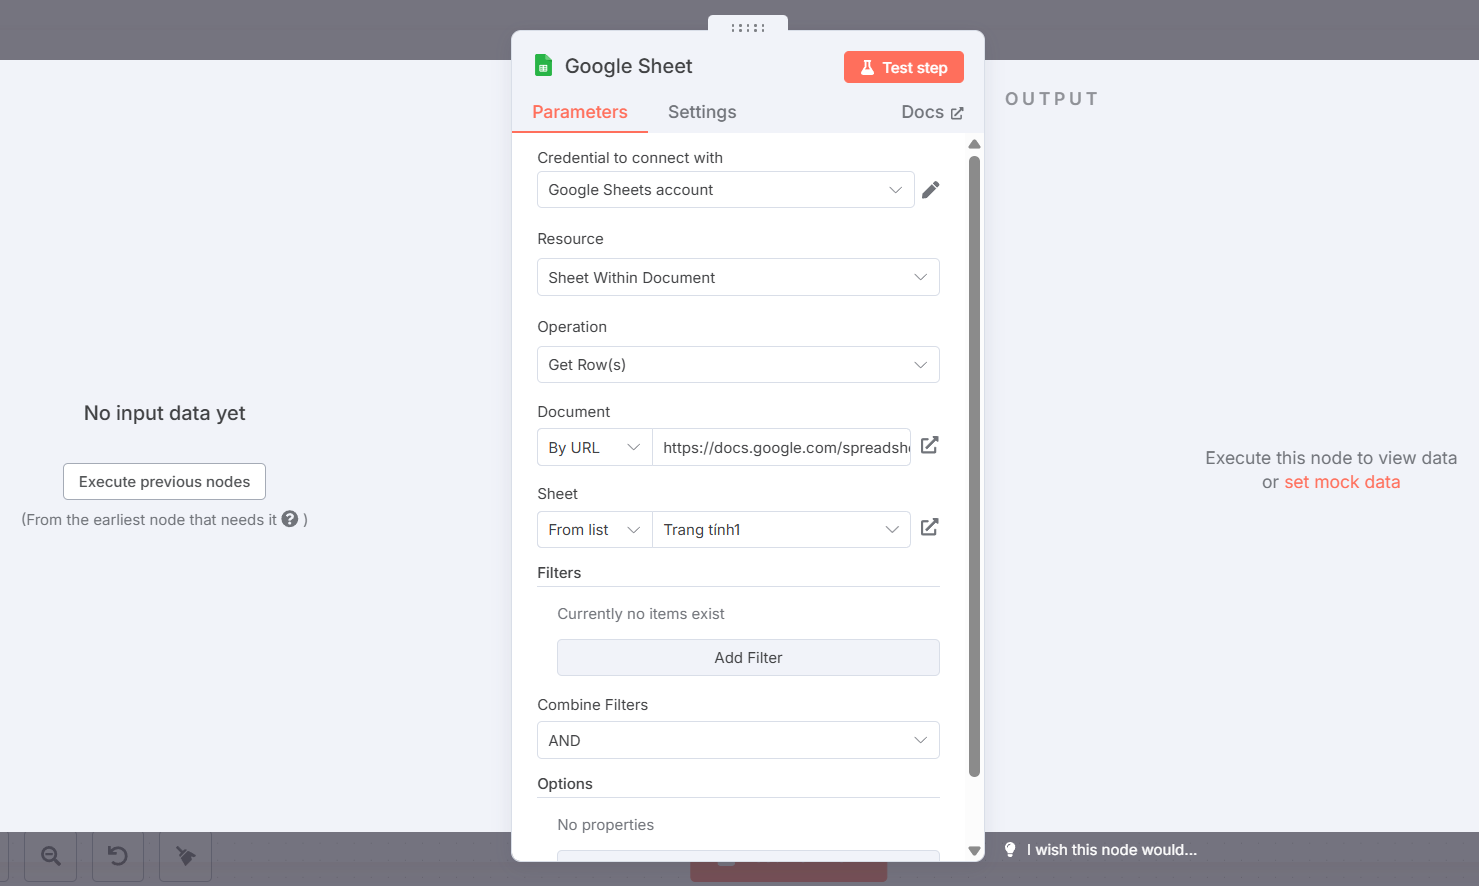
Bước 3: Thêm node HTTP Request (Dumpling AI Crawl Endpoint)
Node HTTP Request là phần crawl dữ liệu, nơi bạn gửi yêu cầu đến API của Dumpling AI để trích xuất nội dung từ các URL. Dumpling AI là dịch vụ cung cấp API crawl website, trả về nội dung đã làm sạch của nhiều trang trong cùng một site.
Trước tiên, bạn đăng nhập Dumpling AI, vào mục API Keys và bấm Generate new secret API Key. Key chỉ hiện một lần, hãy lưu ngay vào credential n8n.
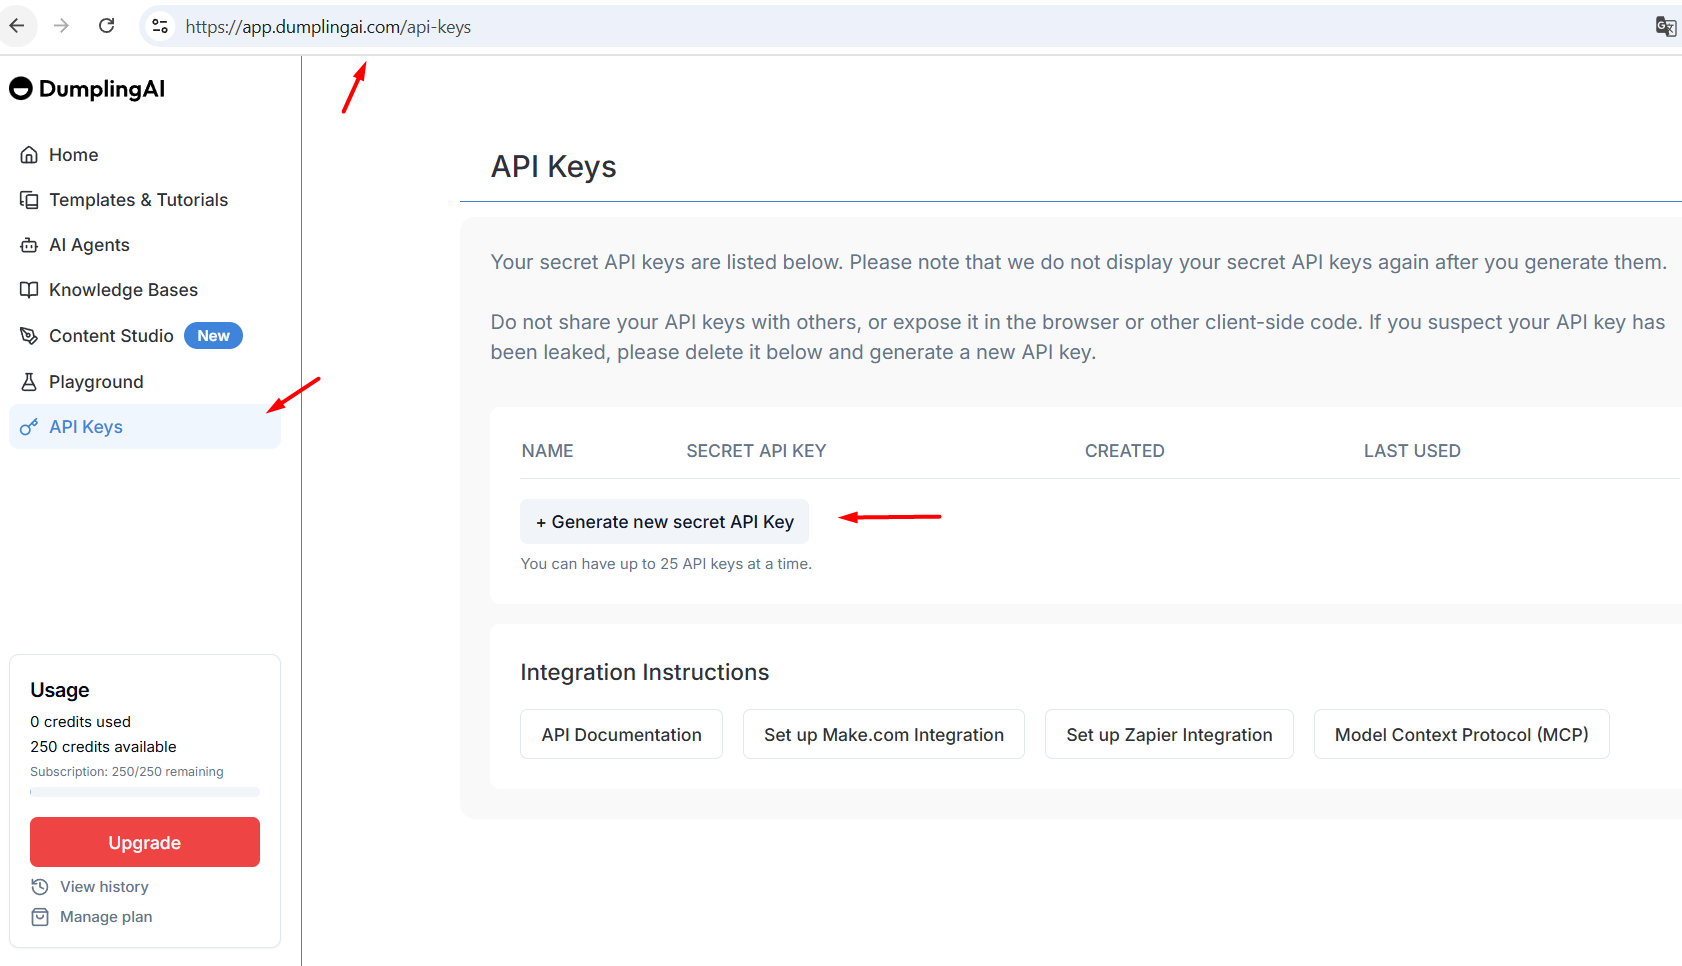

Sau đó, quay lại n8n và cấu hình node HTTP Request:
- Method: Chọn POST.
- URL: Nhập điểm cuối API của Dumpling AI:
https://app.dumplingai.com/api/v1/crawl(đúng theo tài liệu Crawl Website ngày 23/10/2026). - Authentication: Chọn Generic Credential Type.
- Generic Auth Type: Chọn Header Auth.
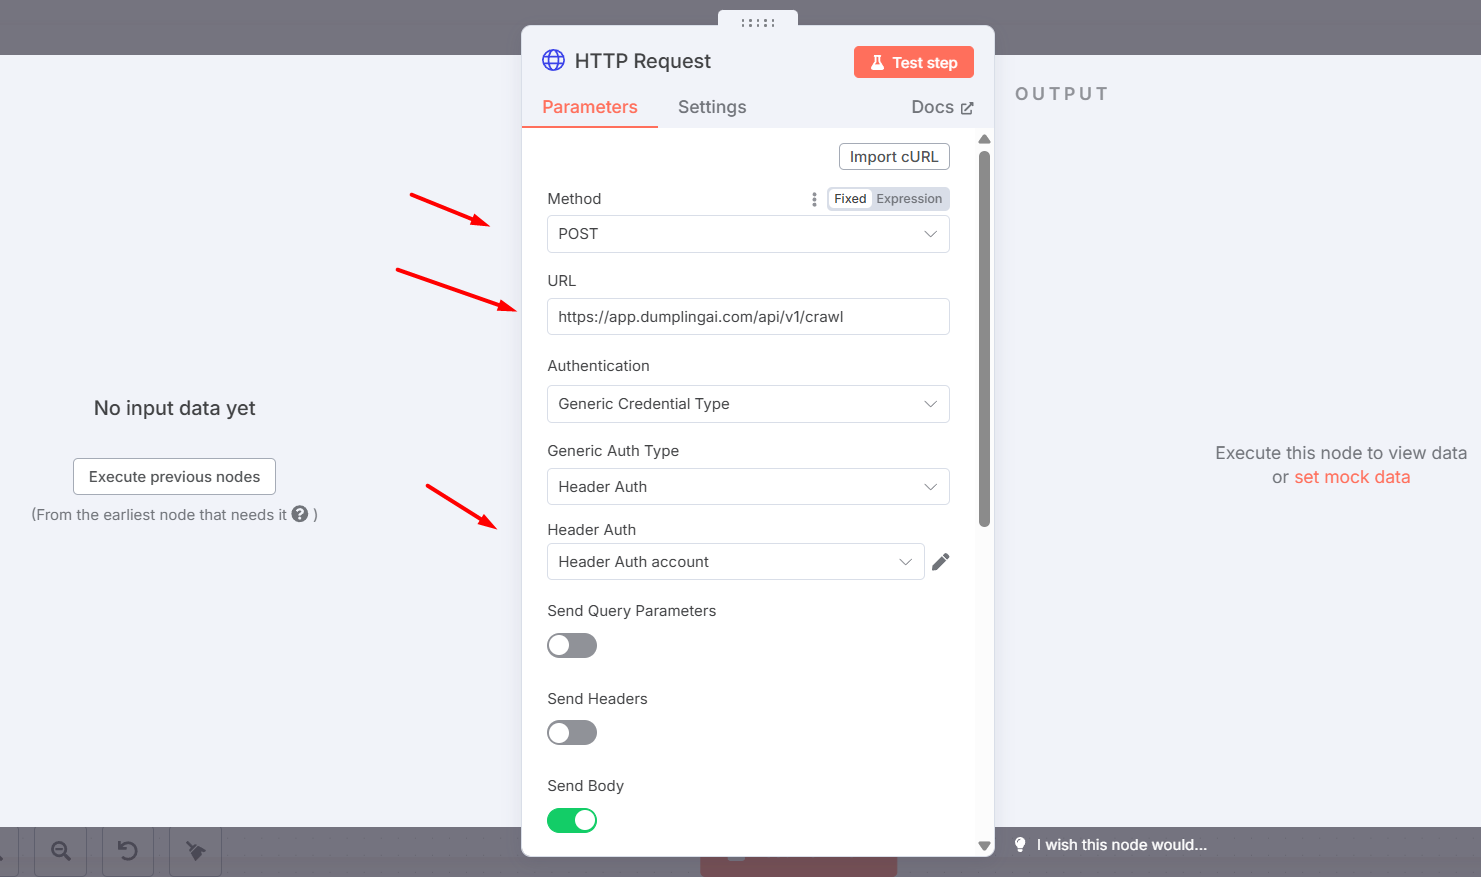
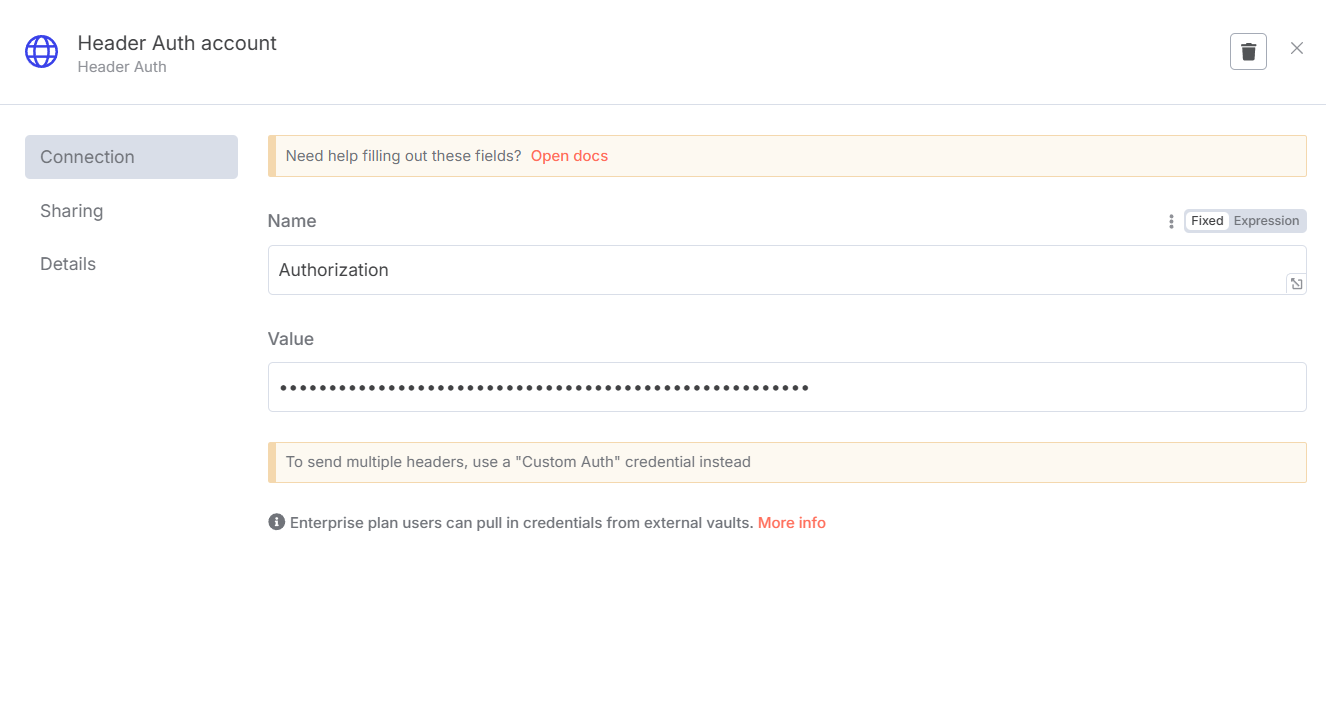
- Header Auth: Tạo một credential Header Auth mới để lưu API Key của Dumpling AI:
- Name: Nhập Authorization.
- Value: Nhập Bearer, một dấu cách, rồi API Key, ví dụ:
Bearer sk_YOUR_API_KEY.
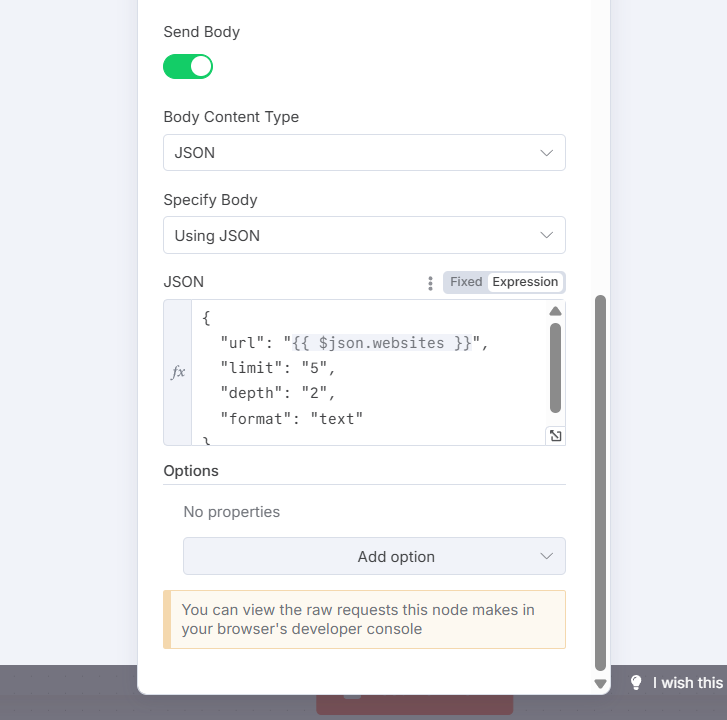
- Send Body: Bật tùy chọn này.
- Body Content Type: Chọn JSON.
- Specify Body: Chọn Using JSON.
- JSON: Nhập cấu trúc JSON sau để gửi các tham số crawl đến Dumpling AI, dùng biểu thức n8n để lấy URL từ node Google Sheet:
- url:
{{ $json.websites }}lấy giá trị ở cộtwebsites. - limit: Số trang tối đa được crawl (mặc định 5).
- depth: Độ sâu crawl tính từ đường dẫn gốc (mặc định 2).
- format: Định dạng nội dung trả về: markdown, text hoặc raw; ở đây là text.
- url:
Theo tài liệu Dumpling AI ngày 23/10/2026, endpoint crawl tốn 10 credit cho mỗi trang được crawl, nên limit 5 nghĩa là tối đa 50 credit mỗi URL. Đặt limit nhỏ khi chạy thử.
Bước 4: Thêm node Split Out
Node Split Out được sử dụng để tách các kết quả trả về từ Dumpling AI thành các mục riêng lẻ, giúp xử lý từng trang một cách độc lập.
Cấu hình chi tiết:
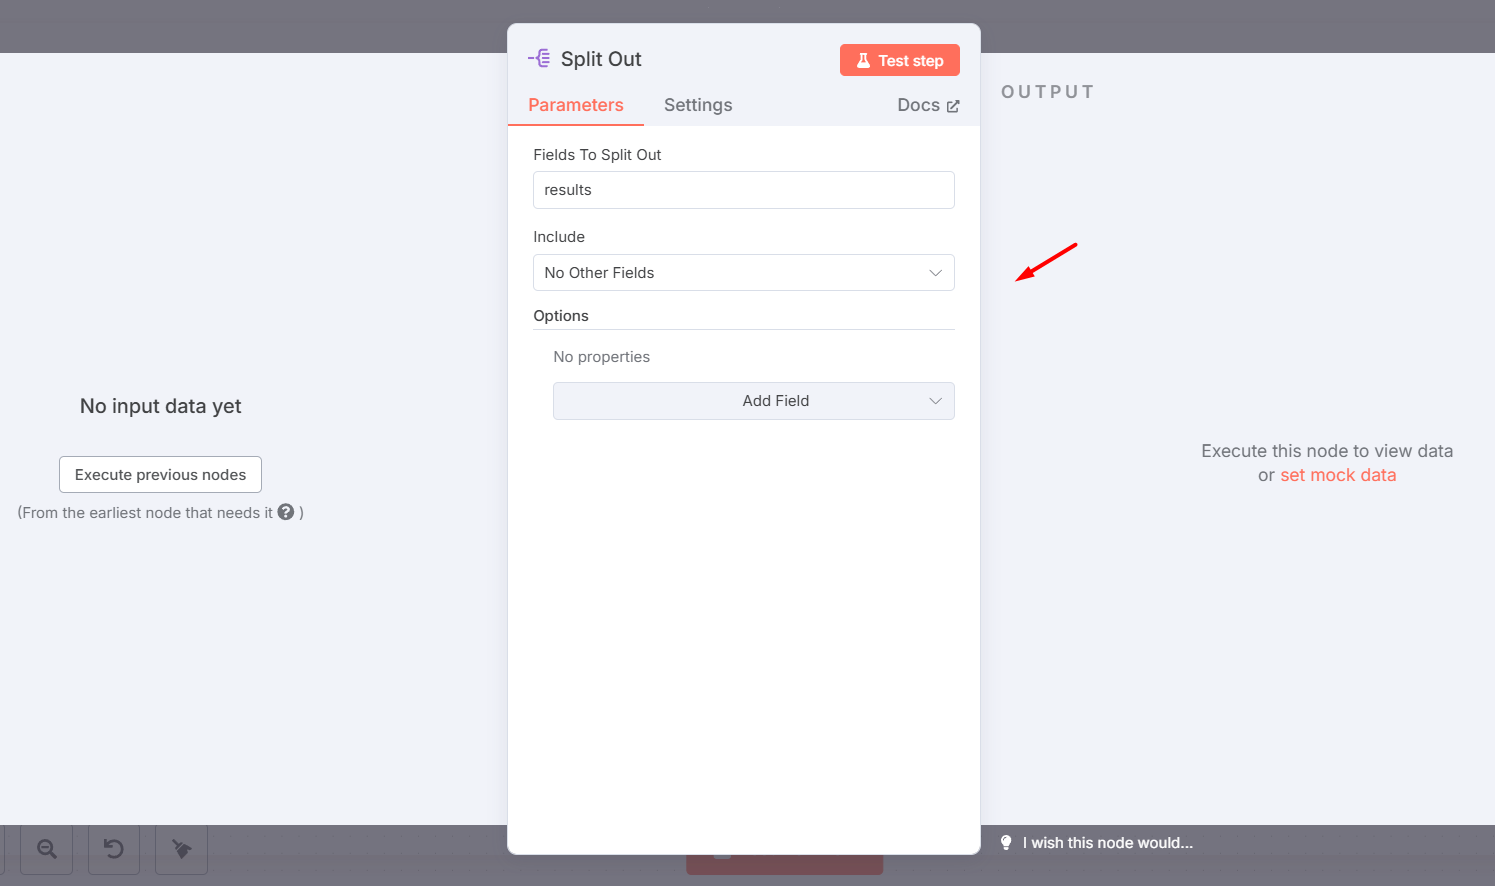
- Fields To Split Out: Nhập results, là mảng kết quả trong phản hồi của Dumpling AI.
- Include: Chọn No Other Fields để chỉ giữ lại các trường đã tách.
Bước 5: Thêm node Edit Fields (Set)
Node Edit Fields (Set) được sử dụng để ánh xạ và chuẩn bị dữ liệu từ mỗi trang đã crawl, đảm bảo rằng các trường cần thiết có sẵn cho các bước tiếp theo của workflow.
Cấu hình chi tiết:
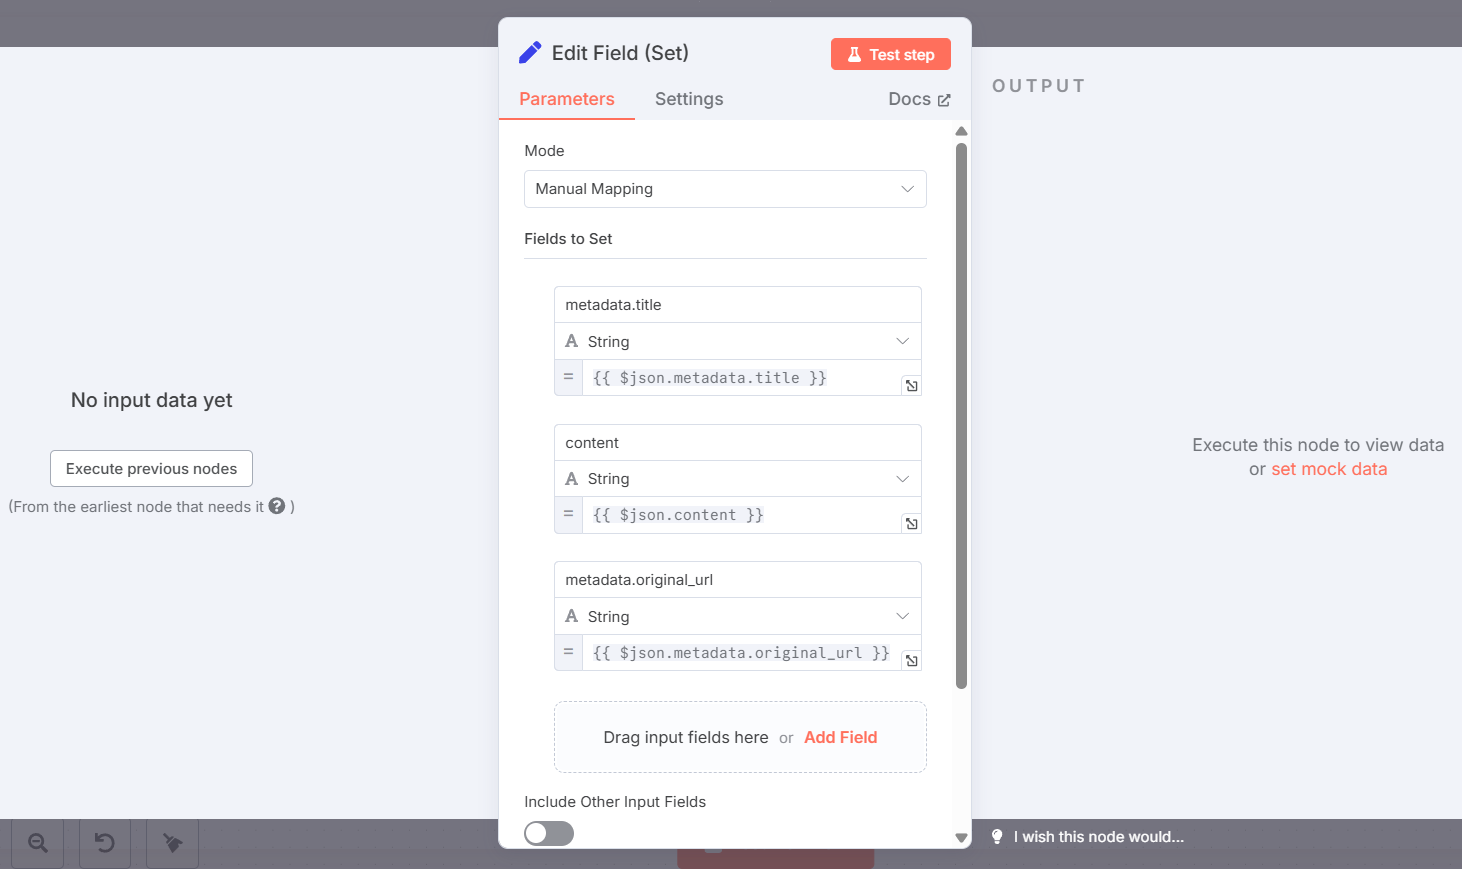
- Mode: Chọn Manual Mapping.
- Fields to Set: Thêm các trường sau và ánh xạ chúng từ dữ liệu JSON đầu vào:
- metadata.title: Kiểu String, giá trị {{ $json.metadata.title }}. Đây là tiêu đề của bài viết.
- content: Kiểu String, giá trị {{ $json.content }}. Đây là nội dung chính của bài viết.
- metadata.original_url: Kiểu String, giá trị {{ $json.metadata.original_url }}. Đây là URL gốc của bài viết.
Lưu ý: tài liệu Dumpling AI hiện mô tả mỗi phần tử results gồm content, url, status. Nếu đầu ra của bạn không có metadata, hãy dùng {{ $json.url }} cho URL và lấy dòng đầu của content làm tiêu đề.
Bước 6: Thêm node Code
Node Code được sử dụng để xử lý và định dạng dữ liệu từ các bài viết đã crawl thành một chuỗi văn bản cho bản tin. Nó cũng tổng hợp thông tin để tạo ra một lời nhắc (prompt) cho AI Agent.
Cấu hình chi tiết:
- Mode: Chọn Run Once for All Items.
- Language: Chọn JavaScript.
- JavaScript Code: Nhập đoạn mã JavaScript sau:
let output = '';

items.forEach((item, index) => {
  const title = item.json.metadata?.title || 'No title';
  const url = item.json.metadata?.original_url || item.json.url || 'No URL';
  const content = item.json.content || 'No content';

  output += `${index + 1}. ${title}\n${url}\n${content}\n\n`;
});

return [{ json: { aggregatedArticles: output } }];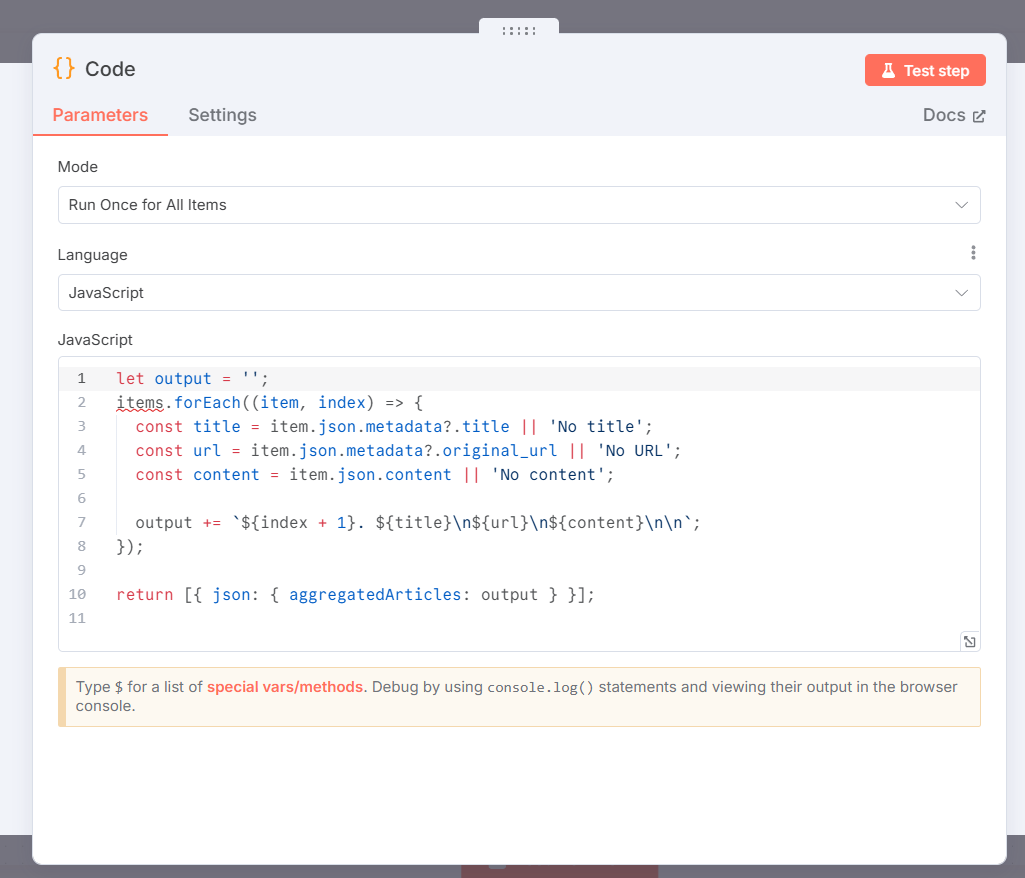
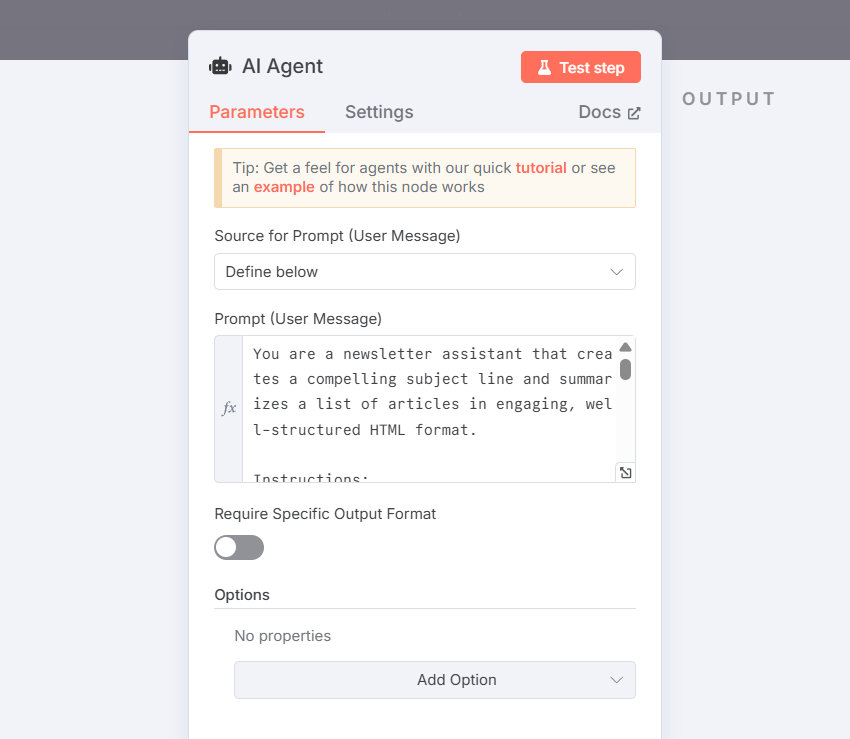
Bước 7: Thêm node AI Agent
Node AI Agent là nơi bạn định nghĩa vai trò và hướng dẫn cho mô hình AI để tạo ra bản tin. Nó hoạt động như một lớp trung gian để làm việc với các mô hình ngôn ngữ lớn như Google Gemini.
Cấu hình chi tiết:
- Source for Prompt (User Message): Chọn Define below.
- Prompt (User Message): Nhập ngữ cảnh cho AI: đóng vai trợ lý bản tin, viết một tiêu đề và bản tóm tắt các bài ở định dạng HTML, trả kết quả dạng JSON có hai trường
subjectvàbody. Mỗi bài tóm tắt kèm link nguồn.
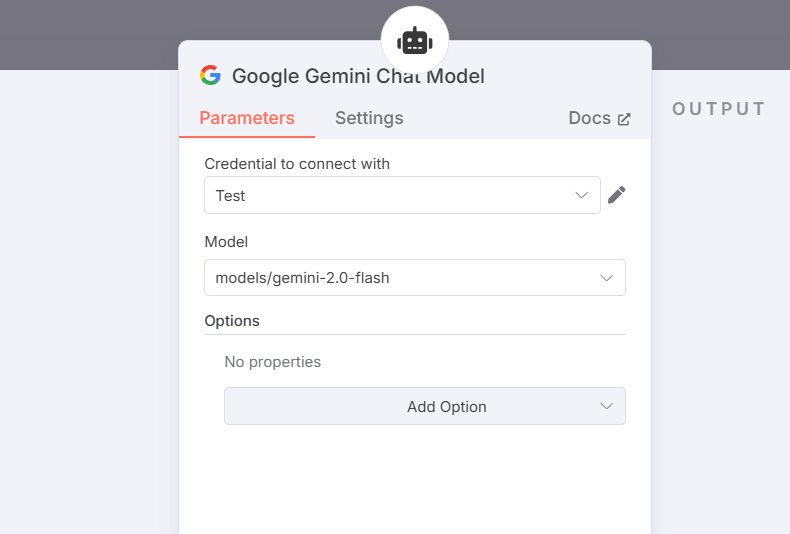
- Chọn Google Gemini Chat Model và chọn credential. Tham khảo bài viết: Hướng dẫn cách lấy API Key của Google Gemini
Lưu ý: Bạn có thể thay node AI Agent này bằng node OpenAI (thao tác Message a Model).
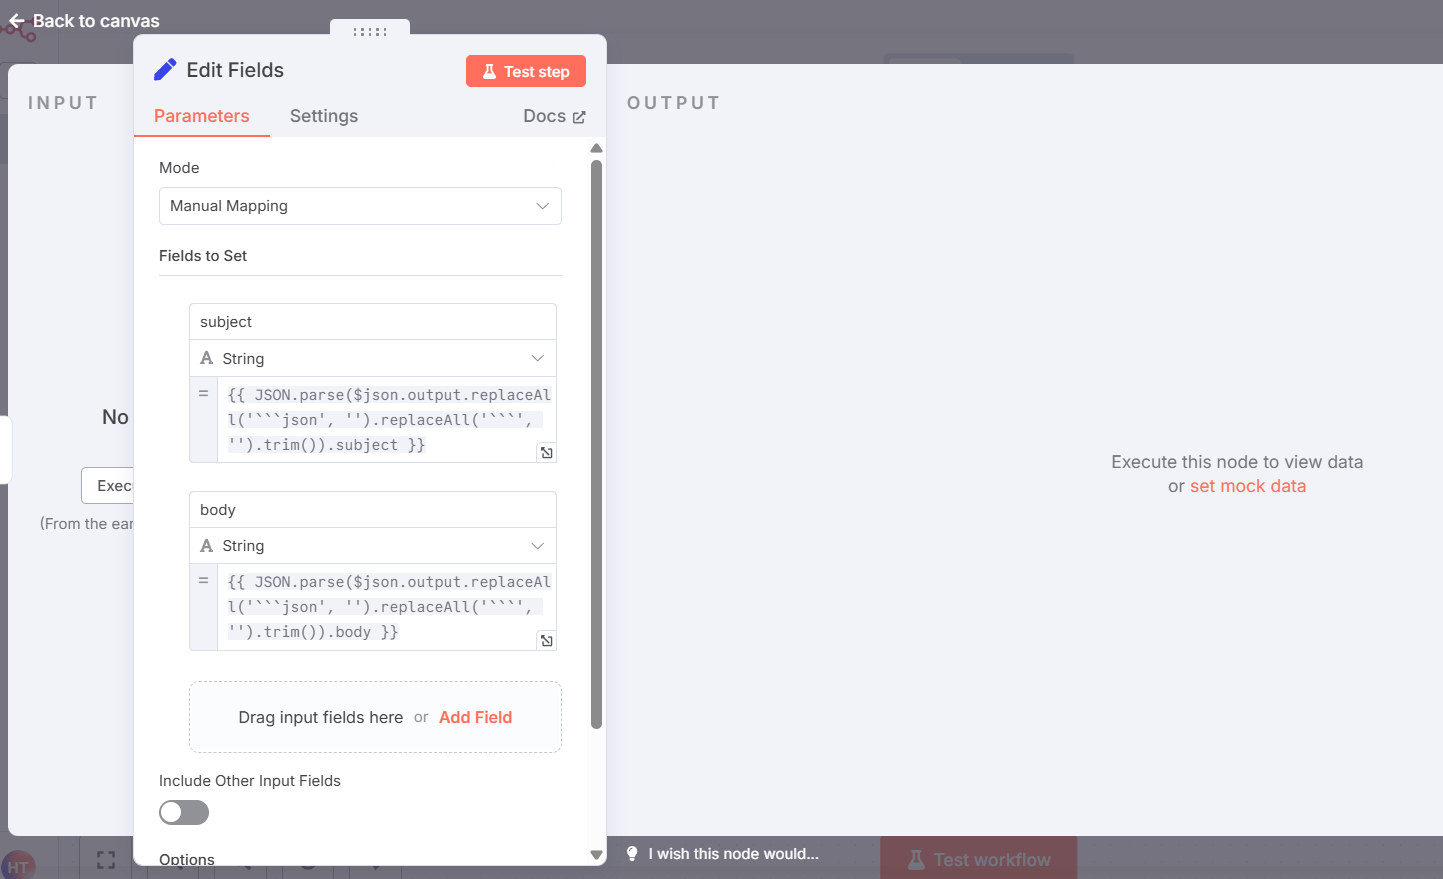
Bước 8: Thêm node Edit Fields
Trong phần “Fields to Set”, tạo 2 trường lấy từ JSON mà AI trả về:
- subject:
{{ JSON.parse($json.output.replaceAll('```json', '').replaceAll('```', '').trim()).subject }} - body:
{{ JSON.parse($json.output.replaceAll('```json', '').replaceAll('```', '').trim()).body }}
Bước 9: Thêm node Gmail
Node Gmail là bước cuối cùng trong workflow, nơi bản tin được tạo bởi AI sẽ được gửi đến địa chỉ email của người nhận.
Cấu hình chi tiết:
- Credential to connect with: Thiết lập credential cho tài khoản Gmail của bạn. Quá trình này sẽ yêu cầu bạn cấp quyền cho n8n để gửi email từ tài khoản của bạn.
- Resource: Chọn Message.
- Operation: Chọn Send.
- To: Nhập địa chỉ email người nhận bản tin, ví dụ:
ten@example.com. Chỉ gửi cho người đã đồng ý nhận. - Subject: Sử dụng biểu thức để lấy tiêu đề bản tin từ bước trước: {{ $json.subject }}.
- Email Type: Chọn HTML.
- Message: Sử dụng biểu thức để lấy nội dung HTML của bản tin: {{ $json.body }}.

Bước 10: Kiểm tra workflow
Nhấn nút Execute workflow và kiểm tra kết quả trong hộp thư. Khi đã ổn, đổi Manual Trigger sang Schedule Trigger và bấm Publish để workflow chạy định kỳ.
Kết quả:

Crawl dữ liệu website có hợp pháp không?
Crawl dữ liệu website không bị cấm chung, nhưng phải tôn trọng robots.txt và điều khoản của trang đích, không thu thập dữ liệu cá nhân trái quy định và không dùng nội dung có bản quyền vượt quá trích dẫn. Phần dưới là nguyên tắc tham khảo, không phải tư vấn pháp lý.
- robots.txt và điều khoản sử dụng: đọc
/robots.txtcủa trang (RFC 9309) và mục điều khoản trước khi crawl. Trang cấm thu thập tự động thì không crawl. - Dữ liệu cá nhân: họ tên, email, số điện thoại, ảnh của người khác là dữ liệu cá nhân theo Nghị định 13/2023/NĐ-CP và Luật Bảo vệ dữ liệu cá nhân 2025 (Luật số 91/2025/QH15). Không gom các dữ liệu này để làm danh sách tiếp thị.
- Bản quyền: chỉ lưu tiêu đề, đoạn tóm tắt và link nguồn; không đăng lại nguyên văn bài của người khác.
- Không gây tải: đặt
limit,depthnhỏ, crawl ngoài giờ cao điểm, không lặp lại liên tục trên cùng một site. - Không vượt rào: trang yêu cầu đăng nhập, CAPTCHA hoặc chặn bot là tín hiệu chủ trang không muốn bị thu thập tự động.
Workflow crawl định kỳ cần n8n chạy liên tục. Nếu tự host, xem cách dựng ở bài cài đặt n8n trên VPS.
Muốn chạy n8n 24/7 mà không tự cài? VPS n8n của Tino cài sẵn n8n trên VPS NVMe đặt tại Việt Nam; bạn vẫn có quyền root để cấu hình. Xem cấu hình và giá trên trang sản phẩm.
Những câu hỏi thường gặp
Vai trò của Dumpling AI trong workflow crawl dữ liệu là gì?
Dumpling AI nhận một URL, tự đi qua các trang con theo limit và depth, rồi trả về nội dung đã làm sạch (bỏ menu, quảng cáo, footer). Nhờ vậy bạn không phải tự viết bộ tách HTML cho từng website.
API Key Dumpling AI lấy ở đâu?
Đăng nhập Dumpling AI, mở mục API Keys, bấm Generate new secret API Key và sao chép ngay vì key chỉ hiện một lần. Lưu key vào n8n dưới dạng credential Header Auth với giá trị Bearer <key>.
Dumpling AI có giới hạn gì không?
Có. Mỗi trang crawl tốn credit (10 credit/trang theo tài liệu ngày 23/10/2026) và tốc độ gọi bị giới hạn theo gói; phản hồi có header X-RateLimit-Remaining để bạn theo dõi. Số credit miễn phí khi đăng ký có thể thay đổi, hãy xem trang giá của Dumpling AI.
Dumpling AI có giới hạn theo domain không?
Dumpling AI không giới hạn domain, nhưng trang chặn crawler, yêu cầu cookie hoặc đăng nhập có thể trả về lỗi hoặc nội dung rỗng. Gặp trường hợp này, hãy coi đó là tín hiệu nên dùng API chính thức của trang hoặc bỏ nguồn đó.
Tại sao nên xử lý kết quả crawl bằng AI?
Nội dung crawl thường dài và lẫn nhiều phần thừa. Node AI Agent giúp tóm tắt, trích các trường cần thiết (giá, ngày, tiêu đề) hoặc dựng bản tin; hãy luôn giữ link nguồn và kiểm lại số liệu AI trích ra.


