LangChain là framework mã nguồn mở (giấy phép MIT) giúp lập trình viên xây dựng ứng dụng và AI agent dựa trên mô hình ngôn ngữ lớn (LLM), bằng Python hoặc JavaScript/TypeScript: nối model với công cụ, dữ liệu riêng và bộ nhớ hội thoại qua một giao diện chung. Bản hiện hành là langchain 1.4.7 (đối chiếu 29/10/2026 trên PyPI). Nếu bạn chưa rõ agent là gì, xem AI agent là gì; model phía sau LangChain vẫn gọi qua API key, xem cách lấy LLM API key miễn phí.
Các mục dưới đây đi từ lý do LangChain ra đời, các thành phần chính, điểm đổi ở bản 1.x, tới một ví dụ code chạy được, ưu nhược điểm và so sánh với LlamaIndex, Semantic Kernel, Haystack.
Giới thiệu đôi nét về LangChain
LangChain là lớp phần mềm nằm giữa ứng dụng của bạn và các LLM như GPT, Claude, Gemini. Thay vì tự viết code gọi API, ghép prompt, gọi công cụ và lưu lịch sử chat cho từng hãng, bạn dùng các khối dựng sẵn của LangChain và chỉ đổi cấu hình khi muốn thay model.
LangChain là gì?
LangChain là framework mã nguồn mở do công ty LangChain, Inc. phát triển, có bản Python và JavaScript/TypeScript. Framework này có chức năng hỗ trợ lập trình viên xây dựng các ứng dụng dựa trên mô hình ngôn ngữ lớn (LLM) như GPT, Claude hay Gemini mà không phải viết lại code cho từng hãng.
Hãy tưởng tượng LLM là một “bộ não” cực kỳ thông minh nhưng bị “nhốt” trong một căn phòng và không biết gì về thế giới bên ngoài hay dữ liệu cá nhân của bạn. LangChain chính là “chất keo” kết nối “bộ não” đó với thế giới thực; cho phép LLM truy cập vào Internet để lấy thông tin mới, “đọc” các tệp PDF hoặc tài liệu của riêng bạn, cũng như kết nối với các API khác.
Với LangChain, bạn có thể làm chatbot hỏi đáp trên tài liệu riêng, trợ lý nội bộ, công cụ tìm kiếm theo ngữ nghĩa hoặc agent biết gọi API. Bạn vẫn cần biết lập trình Python hoặc JavaScript, nhưng không cần là chuyên gia học máy.
Lý do LangChain ra đời
Các mô hình ngôn ngữ lớn (LLM) như GPT, Claude hay Gemini là những công nghệ đột phá, nhưng khi sử dụng chúng một cách “nguyên bản”, chúng ta ngay lập tức vấp phải những giới hạn cố hữu:
- Kiến thức bị giới hạn: Các LLM chỉ biết thông tin đến một thời điểm nhất định (gọi là knowledge cutoff). Chúng hoàn toàn không biết gì về các sự kiện, tin tức, hay dữ liệu mới xuất hiện sau ngày đó.
- “Mù tịt” về dữ liệu cá nhân: LLM không biết gì về bạn. Chúng không thể truy cập vào các tệp tin cá nhân (như PDF, Word), email, cơ sở dữ liệu nội bộ của công ty bạn, hay bất kỳ nguồn dữ liệu riêng tư nào.
- Không thể “hành động”: LLM về cơ bản chỉ là một cỗ máy “chữ vào, chữ ra” (text-in, text-out). Chúng không thể tự mình duyệt web, thực hiện một phép tính toán phức tạp (chính xác), gọi một API để đặt vé máy bay hay tương tác với bất kỳ hệ thống bên ngoài nào.
- Khó kiểm soát và “ảo giác” (Hallucination): Khi được yêu cầu thực hiện các tác vụ phức tạp (ví dụ: “Viết một bài blog 2000 từ về chủ đề X, sau đó tóm tắt và dịch sang tiếng Nhật”), LLM có thể làm tốt một phần nhưng lại “bịa” dữ liệu hoặc đi chệch hướng ở phần còn lại.
LangChain ra đời chính là để giải quyết tất cả những vấn đề trên. Framework này được sinh ra từ nhu cầu “mở khóa” tiềm năng thực sự của LLM, biến chúng từ những “bộ não” thông minh nhưng bị cô lập thành những “tác nhân” (Agent) có khả năng tương tác và hành động trong thế giới thực.
LangChain 1.x khác gì bản cũ?
Từ bản 1.0 (lên PyPI ngày 17/10/2025), LangChain gọn lại quanh một việc chính: dựng agent bằng hàm create_agent. Theo ghi chú phát hành LangChain v1, các chain cũ, retriever cũ và indexing API chuyển sang gói langchain-classic; agent mới chạy trên LangGraph.

create_agentthay choAgentExecutorvàcreate_react_agent: một hàm nhận model, danh sách tool và system prompt.- Middleware: chen logic vào trước/sau mỗi lần gọi model hoặc tool, ví dụ tóm tắt lịch sử dài, che dữ liệu cá nhân, dừng chờ người duyệt.
- Nội dung chuẩn hoá: thuộc tính
content_blocksđọc phần suy luận, chữ, lời gọi tool theo một kiểu chung cho nhiều hãng. - Yêu cầu Python 3.10 trở lên (PyPI, 29/10/2026). Code cũ có hướng dẫn chuyển đổi tại trang migrate v1.
LangGraph là lớp điều phối cấp thấp nằm bên dưới, lo trạng thái, lưu checkpoint và tạm dừng chờ duyệt; xem riêng ở bài LangGraph là gì. Bạn có thể dùng LangChain mà không viết dòng LangGraph nào.
6 thành phần cốt lõi của LangChain
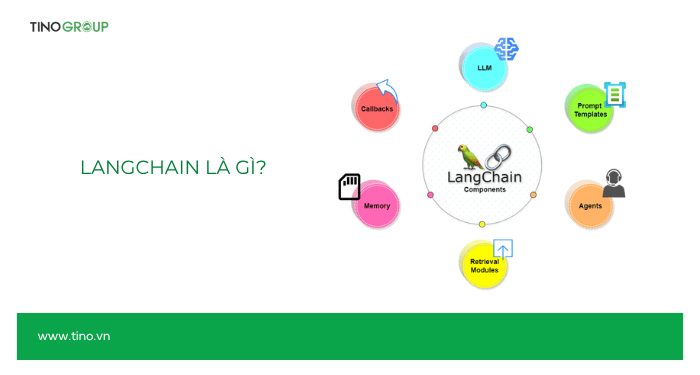
Sáu thành phần dưới đây là cách LangChain chia nhỏ một ứng dụng LLM: model, prompt, chain, retrieval, agent và memory. Tên gọi đến từ các bản 0.x và vẫn hữu ích để hiểu khái niệm; ở bản 1.x, chain và một phần retrieval chuyển sang gói classic, còn agent và memory đi qua create_agent.
1. Models (Mô hình): Giao diện kết nối với “bộ não” AI
Đây không phải là bản thân mô hình AI, mà là lớp giao diện giúp LangChain “nói chuyện” với rất nhiều loại mô hình khác nhau một cách thống nhất. Bạn không cần phải viết code riêng cho OpenAI, rồi lại viết code khác cho Google Gemini hay Claude. LangChain có 3 loại giao diện mô hình:
- LLMs: Giao diện cho model kiểu cũ (nhận văn bản vào, trả văn bản ra); nay ít dùng vì phần lớn model là chat model.
- Chat Models: Giao diện cho các mô hình chuyên về hội thoại (nhận vào một loạt tin nhắn có vai trò như “Người dùng”, “AI”, “Hệ thống” và trả về một tin nhắn).
- Text Embedding Models: Giao diện cho các mô hình chuyên “vector hóa” văn bản, biến các con chữ thành các dãy số (vector) để máy tính có thể so sánh sự tương đồng về ngữ nghĩa.
2. Prompts (Câu lệnh): Nghệ thuật “đặt câu hỏi”
Trong LangChain, “Prompt” không chỉ là một câu hỏi thô. Thành phần này giúp bạn quản lý và tối ưu hóa câu lệnh đầu vào cho LLM.
- Prompt Templates: Đây là một “công thức” tạo ra câu lệnh. Thay vì viết “Thủ đô của Việt Nam là gì?”, bạn tạo một khuôn mẫu: “Thủ đô của {tên_quốc_gia} là gì?”. Sau đó, bạn chỉ cần đưa biến tên_quốc_gia vào.
- Example Selectors: Cho phép bạn tự động chèn thêm các ví dụ (few-shot learning) vào câu lệnh để “hướng dẫn” LLM trả lời đúng ý bạn muốn.
3. Chains (Chuỗi): “Trái tim” của LangChain
Đúng như tên gọi (“Chain” = Chuỗi), đây là khái niệm làm nên tên gọi LangChain. Chains cho phép bạn kết nối nhiều bước xử lý lại với nhau. Một chain đơn giản gồm: Lấy đầu vào -> Định dạng bằng Prompt Template -> Gửi cho Model -> Nhận kết quả.
Tuy nhiên, sức mạnh thực sự nằm ở việc kết nối các chain phức tạp hơn: lấy kết quả của chain này làm đầu vào cho chain kia, tạo ra một quy trình (workflow) tự động hóa phức tạp.
Từ bản 1.0, các lớp chain dựng sẵn như LLMChain nằm trong gói langchain-classic. Code mới thường ghép các bước bằng hàm Python thông thường, hoặc dùng LangGraph khi luồng cần rẽ nhánh và lặp.
4. Retrieval (Truy xuất): Cho phép LLM “đọc” dữ liệu của bạn
Đây là thành phần giúp giải quyết vấn đề “mù thông tin” của LLM. Retrieval là phần chính của kỹ thuật RAG (Retrieval-Augmented Generation) và gồm:
- Document Loaders (Bộ tải tài liệu): “Đọc” dữ liệu từ nhiều nguồn (PDF, .txt, website, cơ sở dữ liệu…).
- Document Transformers (Bộ biến đổi): “Cắt nhỏ” (chunking) các tài liệu lớn thành các đoạn nhỏ hơn để LLM dễ “tiêu hóa”.
- Vector Stores (Kho lưu trữ Vector): Nơi lưu trữ các đoạn tài liệu đã được “vector hóa” (bằng Embedding Models).
- Retrievers (Bộ truy xuất): Khi có câu hỏi, bộ truy xuất sẽ nhanh chóng tìm kiếm trong kho vector để lấy ra các đoạn tài liệu gần nghĩa với câu hỏi và cung cấp chúng cho LLM làm ngữ cảnh.
5. Agents (Tác tử): Trao quyền cho LLM tự suy nghĩ và hành động
Đây là thành phần linh hoạt nhưng cũng khó kiểm soát hơn cả. Nếu “Chain” là một quy trình bạn định sẵn (bước 1, 2, 3), thì “Agent” là một hệ thống mà bạn trao quyền cho LLM tự quyết định phải làm gì.
Bạn cung cấp cho Agent một mục tiêu (ví dụ: “Thời tiết ở TP. Hồ Chí Minh ngày mai thế nào và giá cổ phiếu VinFast hôm nay bao nhiêu?”) và một bộ công cụ (Tools) (ví dụ: Tool 1: Tìm kiếm Google, Tool 2: API thời tiết, Tool 3: API chứng khoán).
Agent sẽ sử dụng LLM làm “bộ não” để suy luận: “À, với câu này, tôi cần dùng API thời tiết cho vế đầu, và API chứng khoán cho vế sau”, sau đó nó tự gọi các tool đó và tổng hợp câu trả lời.
Ở bản 1.x, agent được tạo bằng create_agent, xem ví dụ ở mục bên dưới. Agent có thể dùng tool từ MCP server thông qua gói adapter, nên không phải viết lại tích hợp cho từng dịch vụ.
6. Memory (Bộ nhớ): Giúp Chatbot “nhớ”
Về cơ bản, LLM là “không trạng thái” (stateless), tức là chúng quên ngay lập tức cuộc hội thoại trước đó. Thành phần Memory của LangChain giải quyết điều này. Nó cung cấp một cách thức đơn giản để lưu trữ và truy xuất lịch sử trò chuyện, sau đó tự động chèn các tin nhắn cũ vào bối cảnh (context) của câu hỏi mới. Ở bản 1.x, trí nhớ ngắn hạn được lưu bằng checkpointer theo từng thread_id (mỗi cuộc hội thoại một mã).
LangChain hoạt động như thế nào? (ví dụ minh họa)
LangChain hoạt động theo luồng: nạp dữ liệu, biến dữ liệu thành dạng model dùng được, rồi mỗi lần có câu hỏi thì lấy đúng phần liên quan ghép vào prompt gửi cho LLM. Ví dụ dưới đây dựng chatbot hỏi đáp trên một file PDF dài, chia thành hai giai đoạn: lập chỉ mục và trả lời.
Giả sử bạn có một file PDF 200 trang về luật tài chính và muốn hỏi: “Mức phạt tối đa cho hành vi X là bao nhiêu?” LLM không thể tự đọc file PDF này, vì vậy nó không thể trả lời.
Đây là cách LangChain hoạt động, chia làm 2 giai đoạn:
Giai đoạn 1: “Học” tài liệu (Indexing)
Giai đoạn này giống như việc bạn “dạy” cho hệ thống về dữ liệu của mình. Nó chỉ chạy một lần khi bạn tải file lên.
- Tải tài liệu (Load): LangChain sử dụng DocumentLoader để “đọc” toàn bộ nội dung file PDF của bạn.
- Chia nhỏ (Split): File PDF quá lớn để đưa vào LLM cùng một lúc (giới hạn context). LangChain dùng TextSplitter để “cắt” 200 trang đó thành hàng trăm đoạn nhỏ (ví dụ: mỗi đoạn 500 chữ) nhưng vẫn giữ được ngữ nghĩa.
- Vector hóa (Embed): LangChain dùng một Embedding Model để biến mỗi đoạn văn bản (chữ) thành một dãy số (gọi là vector). Những vector này đại diện cho ý nghĩa ngữ nghĩa của đoạn văn đó. Những đoạn văn có ý nghĩa giống nhau sẽ có vector gần giống nhau.
- Lưu trữ (Store): Tất cả các vector này được lưu vào một cơ sở dữ liệu đặc biệt gọi là VectorStore (kho lưu trữ vector). Đây chính là “bộ nhớ” về tài liệu của bạn.
Giai đoạn 2: “Trả lời” câu hỏi (Querying)
Giai đoạn này xảy ra mỗi khi người dùng đặt câu hỏi.
- Nhận câu hỏi: Người dùng gõ: “Mức phạt tối đa cho hành vi X là bao nhiêu?”
- Vector hóa câu hỏi: LangChain lấy chính xác Embedding Model (ở bước 3) để biến câu hỏi này thành một vector.
- Tìm kiếm (Retrieve): LangChain so sánh vector của câu hỏi với tất cả các vector trong VectorStore (ở bước 4 bên trên) và “rút” ra, ví dụ, 5 đoạn văn bản gốc (chunks) trong file PDF có ý nghĩa gần nhất với câu hỏi. Đây chính là “sự truy xuất” (Retrieval).
- Tạo câu lệnh (Prompt): LangChain tự động tạo một câu lệnh (prompt) mới cho LLM theo khuôn mẫu: “
Dựa vào bối cảnh (context) dưới đây: [Dán vào đoạn văn 1 vừa tìm được] [Dán vào đoạn văn 2 vừa tìm được] [Dán vào đoạn văn 3, 4, 5...], hãy trả lời câu hỏi sau: Mức phạt tối đa cho hành vi X là bao nhiêu?“ - Hỏi LLM (Query LLM): LangChain gửi câu lệnh (prompt) “siêu chi tiết” này đến cho LLM.
- Trả lời: LLM đọc bối cảnh được cung cấp (chỉ vài đoạn văn ngắn) và tổng hợp câu trả lời dựa trên đúng các đoạn đó. Sau đó LLM sẽ trả lời: “Theo tài liệu, mức phạt tối đa cho hành vi X là…”
Ví dụ: tạo agent đầu tiên với LangChain 1.x
Ví dụ dưới đây theo quickstart chính thức: cài thư viện, khai báo một tool là hàm Python, rồi tạo agent bằng create_agent. Code đã chạy thử trên langchain 1.4.7 với Python 3.13; bạn cần một API key của hãng model và đổi tên model sang model tài khoản bạn được dùng.
python -m venv .venv
source .venv/bin/activate        # Windows: .venv\Scripts\activate
pip install -U langchain "langchain[openai]"
export OPENAI_API_KEY="..."        # Windows PowerShell: $env:OPENAI_API_KEY="..."
from langchain.agents import create_agent
from langgraph.checkpoint.memory import InMemorySaver
def get_weather(city: str) -> str:
"""Trả về thời tiết của một thành phố (giả lập)."""
return f"Trời nắng ở {city}."
agent = create_agent(
model="openai:gpt-6-luna", # dạng "hãng:model", đổi theo model bạn dùng
tools=[get_weather],
system_prompt="Bạn là trợ lý trả lời ngắn gọn bằng tiếng Việt.",
checkpointer=InMemorySaver(), # nhớ hội thoại theo thread_id
)
config = {"configurable": {"thread_id": "khach-01"}}
result = agent.invoke({"messages": [{"role": "user", "content": "Thời tiết Đà Nẵng hôm nay?"}]}, config)
print(result["messages"][-1].content)Tên model trong code là gpt-6-luna, model giá thấp của OpenAI theo trang models (đối chiếu 29/10/2026). Muốn dùng Claude hay Gemini, cài gói tương ứng và đổi chuỗi model, ví dụ anthropic:... hoặc google_genai:.... Model ID đổi khá nhanh; xem danh sách hiện hành ở các model của OpenAI, các model Claude.
Bảo mật API key khi chạy LangChain
- Để key trong biến môi trường hoặc trình quản lý secret; không ghi thẳng vào code, không commit file
.envlên repo công khai, không đưa key vào code chạy trên trình duyệt hay app. - Đặt giới hạn chi tiêu (spend limit) trong console của hãng model. Agent tự lặp gọi tool có thể đốt token nhanh hơn bạn nghĩ.
- Nghi lộ key thì thu hồi (revoke) và tạo key mới ngay, sau đó kiểm tra trang Usage.
- Cách lưu credential an toàn trong công cụ workflow: xem bảo mật credentials và API key trong n8n.
Khi agent cần chạy như một dịch vụ 24/7 thay vì trên máy cá nhân, xem các lựa chọn ở bài chọn VPS chạy AI agent.
Ưu – nhược điểm khi sử dụng LangChain
LangChain tiết kiệm thời gian ở những việc lặp lại như gọi nhiều hãng model, nạp tài liệu, gọi tool và lưu hội thoại, đổi lại là thêm một lớp trừu tượng phải học và theo dõi. Bảng ưu nhược dưới đây giúp bạn cân nhắc trước khi đưa LangChain vào dự án.
Ưu điểm
- Hệ sinh thái lớn: Tích hợp sẵn hàng trăm mô hình (OpenAI, Google, Claude…), công cụ (API, Google Search) và cơ sở dữ liệu.
- Tăng tốc phát triển: Giúp xây dựng các ứng dụng phức tạp (như “chat với PDF” – RAG) nhanh hơn tự viết.
- Linh hoạt: Cho phép dễ dàng “tráo đổi” các thành phần (ví dụ: đổi mô hình, đổi cơ sở dữ liệu vector) mà không cần viết lại logic.
- Hỗ trợ Agents: Có sẵn khung để xây dựng các “Tác tử AI” tự chủ, có khả năng suy nghĩ và sử dụng công cụ để hành động.
- Cộng đồng mạnh: Nhờ được sử dụng rộng rãi trong lĩnh vực AI, LangChain có cộng đồng đóng góp mạnh, nhiều ví dụ thực tế và tài nguyên học tập.
Nhược điểm
- Khá phức tạp: Đường cong học tập rất dốc và khó cho người mới bắt đầu.
- Khó gỡ lỗi: Do tính trừu tượng cao, khi một “chain” bị lỗi, việc tìm ra nguyên nhân gốc rễ rất khó khăn.
- Thiếu ổn định: Các Agents thường dựa vào việc LLM trả lời đúng định dạng. Chỉ cần LLM thay đổi một chút, logic có thể hỏng ngay lập tức.
- Thay đổi liên tục: Framework cập nhật nhanh; bản 1.0 (10/2025) đổi nhiều API nên code dùng
LLMChain,AgentExecutorphải chuyển sangcreate_agenthoặc gói classic. - Độ trễ và chi phí: Các chain phức tạp thường yêu cầu nhiều lần gọi API đến LLM, gây chậm (latency) và tốn kém chi phí.
- Hiệu suất chưa tối ưu cho mọi trường hợp: Một số tác vụ nhỏ hoặc mô hình đơn giản có thể chạy chậm hơn nếu sử dụng LangChain vì framework này có nhiều lớp xử lý trung gian.
Khi nào không nên dùng LangChain?
- Ứng dụng chỉ gọi model một lần mỗi yêu cầu, không tool, không truy xuất tài liệu: gọi SDK của hãng trực tiếp sẽ ít phụ thuộc hơn.
- Bạn cần kiểm soát từng request, độ trễ thấp và ít lớp trung gian: mỗi lớp trừu tượng thêm vào là thêm một chỗ phải gỡ lỗi.
- Đội ngũ làm chủ yếu bằng C# hoặc Java: LangChain chỉ có Python và JavaScript, nên cân nhắc framework hỗ trợ ngôn ngữ của bạn (xem bảng so sánh bên dưới).
- Luồng có nhiều nhánh, vòng lặp, cần dừng chờ người duyệt: vẫn dùng được LangChain, nhưng nên làm việc trực tiếp với LangGraph để thấy rõ từng bước.
Ứng dụng thực tế của LangChain
LangChain thường được dùng ở các ứng dụng cần LLM làm việc với dữ liệu riêng hoặc hệ thống bên ngoài: chatbot trên tài liệu nội bộ, hỏi đáp RAG, tóm tắt văn bản, tự động hoá quy trình có AI, tìm kiếm ngữ nghĩa và trợ lý lập trình. Mỗi mục dưới đây kèm ví dụ cụ thể.
Chatbot thông minh và trợ lý ảo tùy chỉnh
LangChain cho phép bạn tạo chatbot có khả năng ghi nhớ ngữ cảnh và hiểu dữ liệu riêng của doanh nghiệp.
Ví dụ:
- Chatbot chăm sóc khách hàng có thể tra cứu thông tin trong cơ sở dữ liệu công ty.
- Trợ lý nội bộ giúp nhân viên tìm tài liệu, báo cáo hoặc chính sách chỉ trong vài giây.
👉 Nhờ tính năng Memory và Retrieval Augmented Generation (RAG), chatbot không chỉ “trả lời cho hay” mà còn phản hồi chính xác theo dữ liệu thực tế.
Hệ thống hỏi – đáp theo tài liệu (Q&A / RAG)
Ứng dụng phổ biến của LangChain là RAG (Retrieval-Augmented Generation) — cơ chế giúp mô hình AI truy xuất thông tin thật trước khi tạo câu trả lời.
Ví dụ:
- Hỏi – đáp theo tài liệu hướng dẫn kỹ thuật.
- Tra cứu chính sách nội bộ của doanh nghiệp.
- Hỗ trợ khách hàng dựa trên dữ liệu sản phẩm.
LangChain giúp tự động phân tích, tách, lưu trữ và tìm kiếm dữ liệu bằng vector, giúp câu trả lời của AI bám sát nguồn thông tin thật hơn.
Tóm tắt và phân tích văn bản tự động
Với LangChain, bạn có thể tạo công cụ tự động đọc và tóm tắt nội dung dài như báo cáo, email, hợp đồng hay bài viết nghiên cứu.
Ứng dụng thực tế:
- Tổng hợp nội dung tin tức theo chủ đề.
- Tóm tắt biên bản cuộc họp hoặc tài liệu kỹ thuật.
- Phân tích ý kiến khách hàng từ phản hồi hoặc review.
Tự động hóa quy trình làm việc (Workflow Automation)
Kết hợp với các công cụ bên ngoài (API, cơ sở dữ liệu, hệ thống CRM…), LangChain có thể giúp bạn xây dựng quy trình tự động sử dụng AI làm trung tâm.
Ví dụ:
- Khi có email mới → LangChain phân tích nội dung → tạo bản trả lời tự động → cập nhật vào hệ thống CRM.
- Khi có dữ liệu sản phẩm mới → LangChain tự động sinh mô tả SEO và đăng lên website.
Công cụ tìm kiếm ngữ nghĩa (Semantic Search)
LangChain hỗ trợ tìm kiếm bằng ngữ nghĩa thay vì từ khóa, nghĩa là AI hiểu ý định người dùng chứ không chỉ khớp chữ.
Ứng dụng:
- Tìm kiếm thông tin trong hàng nghìn file nội bộ.
- Xây dựng công cụ tra cứu tri thức cho doanh nghiệp, trường học, tổ chức nghiên cứu.
Trợ lý lập trình và tài liệu kỹ thuật (Code Assistant)
LangChain có thể được dùng để xây dựng trợ lý hỗ trợ lập trình viên, giúp:
- Giải thích code, gợi ý hàm, tóm tắt logic.
- Tạo tài liệu kỹ thuật tự động.
- Kết hợp cùng GitHub API để phân tích commit hoặc pull request.
Nền tảng xây dựng ứng dụng AI tuỳ chỉnh (AI Application Framework)
LangChain là bộ khung linh hoạt cho các startup hoặc doanh nghiệp muốn phát triển sản phẩm AI riêng — như hệ thống gợi ý thông minh, phân tích dữ liệu khách hàng, hay trợ lý doanh nghiệp nội bộ.
Nếu bạn muốn tự động hoá bằng giao diện kéo thả thay vì viết code, n8n có sẵn node AI dựa trên LangChain; còn muốn một trợ lý AI cá nhân chạy sẵn, xem OpenClaw.
So sánh LangChain với các framework tương tự
LangChain thường được đặt cạnh LlamaIndex, Semantic Kernel và Haystack vì cả bốn đều giúp dựng ứng dụng LLM. Bảng dưới so theo năm tiêu chí: triết lý thiết kế, trường hợp dùng, hệ sinh thái, ngôn ngữ hỗ trợ và đối tượng; ngôn ngữ đối chiếu trang tài liệu chính thức của từng dự án ngày 29/10/2026.
Bốn framework trong bảng: LangChain, LlamaIndex, Semantic Kernel (Microsoft) và Haystack (deepset). Danh sách gốc: LlamaIndex, Semantic Kernel (Microsoft) và Haystack (deepset).
Triết lý cốt lõi và mục tiêu chính
- LangChain: Được định vị là một framework “đa năng” (all-in-one). Triết lý của LangChain xoay quanh tính trừu tượng hóa (abstraction) và khả năng kết hợp (composability). Framework này cung cấp một bộ công cụ toàn diện để lập trình viên “lắp ghép” các thành phần (LLM, công cụ, nguồn dữ liệu) nhằm xây dựng bất kỳ ứng dụng nào, từ RAG đơn giản đến các Tác tử (Agent) tự chủ phức tạp.
- LlamaIndex: Là một framework “chuyên gia về dữ liệu”. Triết lý của LlamaIndex hoàn toàn tập trung vào RAG (Retrieval-Augmented Generation). Framework này không cố gắng làm mọi thứ, mà thay vào đó, tối ưu hóa sâu cho một nhiệm vụ duy nhất: làm thật kỹ khâu nạp (ingest), lập chỉ mục (index) và truy xuất (retrieve) dữ liệu để cung cấp ngữ cảnh cho LLM.
- Semantic Kernel (Microsoft): Là một “SDK cấp doanh nghiệp”. Triết lý của Semantic Kernel nhấn mạnh đến sự ổn định, bảo mật và khả năng tích hợp doanh nghiệp. Giải pháp này được thiết kế như một “bộ điều phối” (orchestrator) gọn nhẹ, cho phép tích hợp các “kỹ năng” (skills) AI vào các ứng dụng .NET, Java hoặc Python hiện hữu một cách an toàn và có cấu trúc.
- Haystack (deepset): Là một “hệ thống tìm kiếm cho production”. Triết lý của Haystack xuất phát từ MLOps và Tìm kiếm (Search). Framework này tập trung vào việc xây dựng các “pipeline” (luồng xử lý) tìm kiếm ngữ nghĩa và RAG sẵn sàng cho môi trường production, có khả năng mở rộng (scalable) và giám sát (monitorable).
Trường hợp sử dụng phù hợp
- LangChain: Phù hợp khi xây dựng Tác tử tự chủ (Autonomous Agents). Đây là các hệ thống phức tạp, nơi LLM được trao quyền tự suy luận, lập kế hoạch và quyết định sử dụng công cụ nào để hoàn thành một mục tiêu.
- LlamaIndex: Phù hợp với RAG nâng cao. Bất cứ khi nào ứng dụng yêu cầu “trò chuyện với dữ liệu” (dù là PDF, SQL hay API), LlamaIndex sẽ cung cấp các kỹ thuật truy xuất và lập chỉ mục tiên tiến (ví dụ: graph RAG, query transformations) được làm chuyên sâu.
- Semantic Kernel: Phù hợp khi cần tích hợp vào ứng dụng doanh nghiệp. Khi cần bổ sung chức năng AI (ví dụ: “tóm tắt email này”) vào một ứng dụng .NET hoặc Java quy mô lớn, Semantic Kernel được thiết kế cho mục đích này.
- Haystack: Phù hợp với hệ thống tìm kiếm ngữ nghĩa quy mô lớn. Khi doanh nghiệp cần xây dựng một “Google nội bộ” cho hàng triệu tài liệu, đòi hỏi sự ổn định, tốc độ và khả năng vận hành (MLOps).
Hệ sinh thái và khả năng tích hợp
- LangChain: Rộng. Có hàng trăm tích hợp cho mọi thành phần: từ các LLM khác nhau, cơ sở dữ liệu vector, cho đến các API và trình tải dữ liệu.
- LlamaIndex: Sâu về dữ liệu. Hệ sinh thái tập trung chuyên sâu vào các trình kết nối dữ liệu (data connectors) và cơ sở dữ liệu vector. Framework này có các trình phân tích (parser) chuyên dụng cho các loại tệp phức tạp (như PDF có bảng biểu) khá tốt.
- Semantic Kernel: Tập trung. Hệ sinh thái tập trung mạnh vào các sản phẩm của Microsoft (Azure, Microsoft 365). Số lượng tích hợp không nhiều bằng LangChain, nhưng các tích hợp hiện có rất chặt chẽ và đáng tin cậy.
- Haystack: Tập trung vào Production. Hệ sinh thái tập trung vào các công cụ cần thiết cho môi trường production như Elasticsearch, OpenSearch và các công cụ giám sát hiệu suất AI.
Ngôn ngữ lập trình hỗ trợ
- LangChain: Python và JavaScript (TypeScript). Hai bản được phát triển song song.
- LlamaIndex: Python và JavaScript (TypeScript). Bản Python là chủ đạo, nhiều tính năng hơn.
- Semantic Kernel: C#, Python, và Java. Hỗ trợ C# và Java là điểm khác biệt chính, nhắm vào doanh nghiệp.
- Haystack: Chỉ hỗ trợ Python.
Đối tượng người dùng mục tiêu
- LangChain: Lập trình viên, nhà nghiên cứu, và các startup (những người cần thử nghiệm ý tưởng nhanh và linh hoạt tối đa).
- LlamaIndex: Kỹ sư AI, Kỹ sư dữ liệu (những người tập trung chuyên sâu vào chất lượng và hiệu suất của hệ thống RAG).
- Semantic Kernel: Lập trình viên doanh nghiệp (Enterprise Developers), đặc biệt là các tổ chức sử dụng .NET hoặc Java.
- Haystack: Kỹ sư vận hành AI/ML (MLOps Engineers), Kỹ sư dữ liệu (những người cần xây dựng hệ thống production ổn định, quy mô lớn).
Câu hỏi thường gặp
LangChain có phải là một LLM không?
Không. LangChain không phải mô hình ngôn ngữ mà là công cụ để điều phối và xây dựng ứng dụng bằng các LLM như GPT (OpenAI), Claude (Anthropic) hay Gemini (Google).
LangChain có miễn phí không?
Thư viện LangChain là mã nguồn mở, giấy phép MIT (PyPI, 29/10/2026), không thu phí khi dùng. Chi phí đến từ API model (tính theo token), cơ sở dữ liệu vector và máy chủ chạy ứng dụng; xem cách tính token và credit của AI.
Tại sao tôi cần LangChain? Không thể dùng trực tiếp API của OpenAI sao?
Bạn có thể dùng trực tiếp API cho tác vụ đơn giản như hỏi đáp một lần. LangChain có ích khi LLM cần đọc tài liệu vài trăm trang, gọi công cụ, nhớ hội thoại hoặc đổi qua lại giữa nhiều hãng model.
LangSmith là gì? Có phải là LangChain không?
LangSmith là nền tảng thương mại của LangChain, Inc. để trace, gỡ lỗi và đánh giá ứng dụng LLM khi chạy thật. Nó không phải framework; ứng dụng LangChain chạy được mà không cần LangSmith.