



RAG (Retrieval-Augmented Generation, sinh văn bản có truy xuất) là kỹ thuật cho mô hình ngôn ngữ lớn tìm các đoạn tài liệu liên quan trong kho dữ liệu của bạn rồi dựa vào đó để trả lời, thay vì chỉ dùng kiến thức đã học khi huấn luyện. Nhờ vậy câu trả lời bám sát tài liệu nội bộ, cập nhật hơn và có thể trích nguồn.
RAG là thành phần hay gặp trong AI agent dùng cho hỏi đáp tài liệu, chăm sóc khách hàng. Phần model phía sau thường gọi qua API key, xem cách lấy LLM API key miễn phí. Nửa sau bài hướng dẫn dựng thử RAG bằng mẫu có sẵn của n8n.
RAG là gì?
RAG là cách ghép hai bước: truy xuất (retrieval) tìm đoạn văn bản phù hợp với câu hỏi trong một kho tài liệu, và sinh (generation) để LLM viết câu trả lời dựa trên các đoạn đó. Model không cần huấn luyện lại; muốn cập nhật kiến thức, bạn chỉ cần cập nhật kho tài liệu.
Thuật ngữ này xuất phát từ bài nghiên cứu “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks” của Patrick Lewis và cộng sự, đăng ngày 22/05/2020 (arXiv 2005.11401), trong đó model sinh văn bản được nối với một chỉ mục vector của Wikipedia để tra cứu khi trả lời.
Thay vì chỉ dựa hoàn toàn vào kho kiến thức tĩnh đã được huấn luyện từ trước – vốn thường bị giới hạn về thời gian cập nhật và thiếu tính chuyên sâu – quy trình RAG sẽ truy xuất các đoạn thông tin liên quan nhất và cung cấp chúng làm ngữ cảnh đầu vào cho AI.
Nhờ cơ chế kết hợp chặt chẽ giữa khả năng tìm kiếm dữ liệu và năng lực sinh văn bản tự nhiên, giải pháp này giúp giảm hiện tượng “ảo giác” thông tin, đồng thời giúp câu trả lời sát với bối cảnh thực tế của doanh nghiệp mà không cần tốn kém chi phí để tái huấn luyện mô hình.
RAG hoạt động như thế nào?
Một hệ thống RAG có hai luồng. Luồng nạp chạy một lần trước khi dùng: tài liệu được cắt nhỏ, mỗi mẩu đổi thành vector bằng mô hình embedding rồi cất vào kho vector. Luồng hỏi chạy với từng câu hỏi: tìm những mẩu có nghĩa sát nhất, ghép vào prompt, rồi để LLM viết câu trả lời.

Quy trình vận hành của kỹ thuật RAG gồm ba giai đoạn: Truy xuất (Retrieval), Tăng cường (Augmentation) và Tạo sinh (Generation).
Đầu tiên, toàn bộ dữ liệu nguồn (tài liệu, văn bản, thông tin sản phẩm) sẽ được chuyển đổi thành các vectơ số học (embeddings) và lưu trữ trong một cơ sở dữ liệu vectơ chuyên dụng. Khi người dùng gửi một câu hỏi hoặc yêu cầu, hệ thống sẽ thực hiện chuyển đổi câu lệnh đó thành vectơ tương ứng và quét qua cơ sở dữ liệu để tìm kiếm những đoạn thông tin có nội dung hoặc ngữ nghĩa tương đồng nhất.
Tiếp theo, ở giai đoạn tăng cường, các đoạn thông tin vừa tìm được sẽ được ghép nối với câu hỏi gốc của người dùng để tạo thành một ngữ cảnh đầu vào đầy đủ và chi tiết.
Cuối cùng, mô hình ngôn ngữ lớn (LLM) sẽ tiếp nhận toàn bộ khối thông tin đã được làm giàu này. Thay vì phải tự suy diễn dựa trên dữ liệu huấn luyện cũ, AI sẽ sử dụng ngữ cảnh được cung cấp để tổng hợp và soạn thảo câu trả lời sát với tài liệu và nhu cầu của người hỏi.
Vì sao RAG quan trọng với doanh nghiệp?
Mô hình ngôn ngữ không biết tài liệu nội bộ của bạn và không biết những gì xảy ra sau thời điểm huấn luyện. RAG lấp khoảng trống đó với chi phí thấp hơn huấn luyện lại, lại giữ được nguồn để kiểm tra câu trả lời. Các lợi ích chính:
- Đảm bảo tính chính xác và cập nhật: Các mô hình AI truyền thống thường bị giới hạn bởi thời điểm kết thúc huấn luyện, dẫn đến việc thiếu hụt thông tin mới nhất. RAG cho phép hệ thống truy cập vào dữ liệu thời gian thực hoặc tài liệu nội bộ vừa được cập nhật, giảm tình trạng trả lời theo thông tin lỗi thời.
- Khắc phục hiện tượng “ảo giác” của AI: Một rủi ro lớn khi dùng AI là việc mô hình tự bịa đặt thông tin khi không biết câu trả lời. Bằng cách buộc AI phải dựa trên nguồn dữ liệu được cung cấp để phản hồi, kỹ thuật RAG giúp giảm rủi ro sai lệch thông tin, tăng độ tin cậy cho các ứng dụng chăm sóc khách hàng hay tư vấn tự động.
- Tối ưu hóa chi phí và nguồn lực: Việc huấn luyện lại (Fine-tuning) một mô hình ngôn ngữ lớn để học thêm kiến thức mới thường tốn kém rất nhiều chi phí tính toán và thời gian. Ngược lại, việc cập nhật cơ sở dữ liệu cho hệ thống RAG diễn ra nhanh chóng, đơn giản và tiết kiệm chi phí hơn nhiều.
- Bảo mật dữ liệu nội bộ: Kho tài liệu do doanh nghiệp tự giữ và phân quyền, không cần đưa vào huấn luyện model. Lưu ý: các đoạn được truy xuất vẫn được gửi kèm prompt tới nhà cung cấp model, nên cần đọc chính sách dữ liệu của nhà cung cấp hoặc dùng model chạy nội bộ với tài liệu nhạy cảm.
Khi nào không nên dùng RAG?
RAG chỉ tốt bằng phần truy xuất: tìm sai đoạn thì model trả lời sai một cách tự tin. Kỹ thuật này hợp với hỏi đáp trên tài liệu, nhưng không phải cách đúng cho mọi bài toán, nhất là khi câu hỏi cần tính toán trên toàn bộ dữ liệu hoặc cần đổi văn phong của model.
- Câu hỏi cần thống kê, đếm, lọc trên toàn bộ dữ liệu (doanh thu theo quý, số đơn lỗi): truy vấn SQL hoặc công cụ phân tích chính xác hơn, vì RAG chỉ lấy vài đoạn.
- Muốn model đổi giọng văn, định dạng hay hành vi cố định: chỉnh system prompt hoặc fine-tune phù hợp hơn thêm tài liệu.
- Kho tài liệu nhỏ, ít thay đổi: đưa thẳng vào ngữ cảnh của model có ngữ cảnh dài có thể đơn giản hơn dựng vector database.
- Tài liệu sai, cũ hoặc mâu thuẫn: RAG sẽ lặp lại lỗi đó; cần quy trình cập nhật và gỡ tài liệu hết hiệu lực.
RAG và MCP khác nhau thế nào?
RAG giúp model “biết” bằng cách tra đúng đoạn tài liệu, còn MCP là giao thức giúp model “làm” bằng cách gọi công cụ và hệ thống bên ngoài. Hai kỹ thuật không thay thế nhau; nhiều agent dùng RAG để tra chính sách rồi dùng MCP để thực hiện thao tác trong phần mềm.
Bảng so sánh nhanh RAG vs MCP:
Tiêu chí RAG (Retrieval-Augmented Generation) MCP (Model Context Protocol) Mục tiêu chính Truy xuất thông tin để trả lời câu hỏi chính xác hơn. Chuẩn hóa kết nối để AI thực hiện hành động hoặc dùng công cụ. Loại dữ liệu Dữ liệu phi cấu trúc (PDF, Docx, Text) hoặc bán cấu trúc. Dữ liệu cấu trúc, API, Database, và các công cụ hệ thống. Cơ chế hoạt động Tìm kiếm đoạn văn bản tương đồng -> Gửi kèm ngữ cảnh cho AI -> AI sinh câu trả lời. Giao thức chuẩn giữa host, client và server để AI gọi tool, đọc tài nguyên hoặc thao tác trên ứng dụng khác. Tính chất Chủ yếu đọc và tổng hợp thông tin. Có thể ghi, sửa, xoá hoặc kích hoạt quy trình, tuỳ quyền của tool. Ví dụ điển hình Chatbot hỏi đáp về quy định nhân sự nội bộ. Trợ lý AI tự động kiểm tra lịch, đặt phòng họp và gửi email xác nhận. Hình tượng Như một Thủ thư: Tra cứu sách để tìm thông tin bạn cần. Như cổng USB-C: Một chuẩn kết nối chung cho nhiều thiết bị ngoại vi.
Mối quan hệ tương hỗ
Hai công nghệ này không loại trừ nhau mà thường kết hợp trong một AI agent:
- RAG giải quyết vấn đề “Biết”: Cung cấp kiến thức nền tảng chính xác.
- MCP giải quyết vấn đề “Làm”: Cung cấp khả năng thao tác.
Ví dụ: Một hệ thống chăm sóc khách hàng có thể dùng RAG để tra cứu chính sách bảo hành (tìm thông tin), sau đó dùng MCP để truy cập hệ thống CRM và tạo phiếu bảo hành cho khách (thực hiện hành động).
Khi nào nên dùng công nghệ nào?
- Chọn RAG khi: Nhu cầu chính là tra cứu, tóm tắt tài liệu, giải đáp thắc mắc dựa trên kho tri thức tĩnh.
- Chọn MCP khi: Cần tích hợp AI với nhiều hệ thống phần mềm khác nhau để tự động hóa quy trình hoặc khi cần chuẩn hóa cách các AI Agent giao tiếp với nhau.
Xem thêm: MCP là gì và MCP server hoạt động ra sao, MCP khác API thế nào.
Vai trò của n8n trong việc triển khai RAG
n8n có sẵn các node AI cho từng thành phần của RAG: nạp tài liệu, chia đoạn, embedding, vector store và AI agent. Bạn ghép chúng bằng giao diện kéo thả thay vì tự viết code tích hợp, và đổi nhà cung cấp model hay vector database bằng cách thay node.
Thay vì phải viết hàng trăm dòng mã lệnh bằng Python hay JavaScript để tích hợp các thư viện như LangChain, người dùng n8n có thể thực hiện toàn bộ quy trình thông qua giao diện kéo thả trực quan. Nền tảng này cung cấp sẵn các nút chức năng (nodes) chuyên dụng cho AI, cho phép thiết lập luồng xử lý dữ liệu từ khâu thu thập, mã hóa (embedding) đến khâu truy xuất và tạo câu trả lời chỉ trong thời gian ngắn.
Ngoài ra, n8n linh hoạt về nhà cung cấp. Người quản trị có thể dễ dàng thay đổi nhà cung cấp mô hình AI (ví dụ: chuyển từ OpenAI sang Anthropic hoặc các mô hình Local LLM) mà không làm gián đoạn quy trình vận hành. Khi tự host n8n, bạn kiểm soát nơi lưu workflow và credential; dữ liệu gửi tới API model vẫn theo chính sách của nhà cung cấp đó.
Các thành phần cần thiết để xây dựng RAG trong n8n
Một quy trình RAG trong n8n cần bốn thành phần: chat model để trả lời, vector store để lưu và tìm đoạn văn bản, mô hình embedding để đổi văn bản thành vector, và các node nạp, chia nhỏ tài liệu. Mỗi thành phần là một node riêng, có thể thay nhà cung cấp mà không đổi cả luồng.
Mô hình ngôn ngữ lớn (Chat Model)
Đây là bộ não của toàn bộ hệ thống, chịu trách nhiệm tiếp nhận thông tin và sinh ra câu trả lời tự nhiên. Trong n8n, thành phần này thường được kết nối thông qua các node như OpenAI Chat Model, Gemini Chat Model, Anthropic Chat Model (Claude) hoặc Ollama Chat Model (dành cho các mô hình chạy cục bộ). Việc lựa chọn mô hình nào sẽ phụ thuộc vào yêu cầu về độ thông minh, tốc độ phản hồi và ngân sách của dự án.
Cơ sở dữ liệu Vector
Thành phần này đóng vai trò là kho lưu trữ kiến thức dài hạn cho AI. Dữ liệu văn bản sau khi được xử lý sẽ được lưu tại đây dưới dạng các dãy số (vectơ). n8n hỗ trợ tích hợp với nhiều nhà cung cấp Vector Store phổ biến như Pinecone, Qdrant, Supabase hoặc Weaviate. Vector Store đảm nhiệm chức năng tìm kiếm và truy xuất nhanh chóng các đoạn thông tin có ý nghĩa tương đồng với câu hỏi của người dùng.
Mô hình Embeddings
Để máy tính có thể hiểu và so sánh được sự tương đồng giữa các văn bản, dữ liệu cần phải được chuyển đổi thành dạng số học. Mô hình Embeddings thực hiện nhiệm vụ chuyển đổi văn bản đầu vào (câu hỏi và tài liệu) thành các vectơ. Trong n8n, người dùng cần kết nối thành phần này (thường dùng chung nhà cung cấp với Chat Model như OpenAI Embeddings) vào cả hai quy trình: nạp dữ liệu vào kho và truy vấn dữ liệu ra.
Công cụ tải và xử lý dữ liệu
Trước khi đưa vào lưu trữ, dữ liệu thô cần được xử lý sơ bộ.
- Document Loader: Các node này giúp n8n đọc được nội dung từ nhiều định dạng khác nhau như tệp PDF, Google Docs, Notion hoặc nội dung trang web.
- Text Splitter: Vì các mô hình AI có giới hạn về độ dài đầu vào, công cụ chia nhỏ văn bản (Text Splitter) sẽ cắt tài liệu lớn thành các đoạn nhỏ (chunks) để đảm bảo việc tìm kiếm diễn ra chính xác và hiệu quả hơn.
Hướng dẫn cách tạo RAG trên n8n (sử dụng mẫu có sẵn đơn giản)
Cách nhanh để thử RAG là mẫu “RAG starter template” có sẵn trong n8n: một luồng tải tệp vào vector store, một luồng chat hỏi đáp trên tệp đó. Ảnh chụp giao diện n8n tháng 12/2025, phiên bản mới có thể đã đổi. Mẫu dùng OpenAI nên bạn cần tạo credential OpenAI trong n8n trước.
Khởi tạo từ mẫu “RAG starter template”
Bước 1: Tại giao diện tạo workflow mới, hãy tìm kiếm từ khóa “RAG” trong thanh công cụ bên phải.
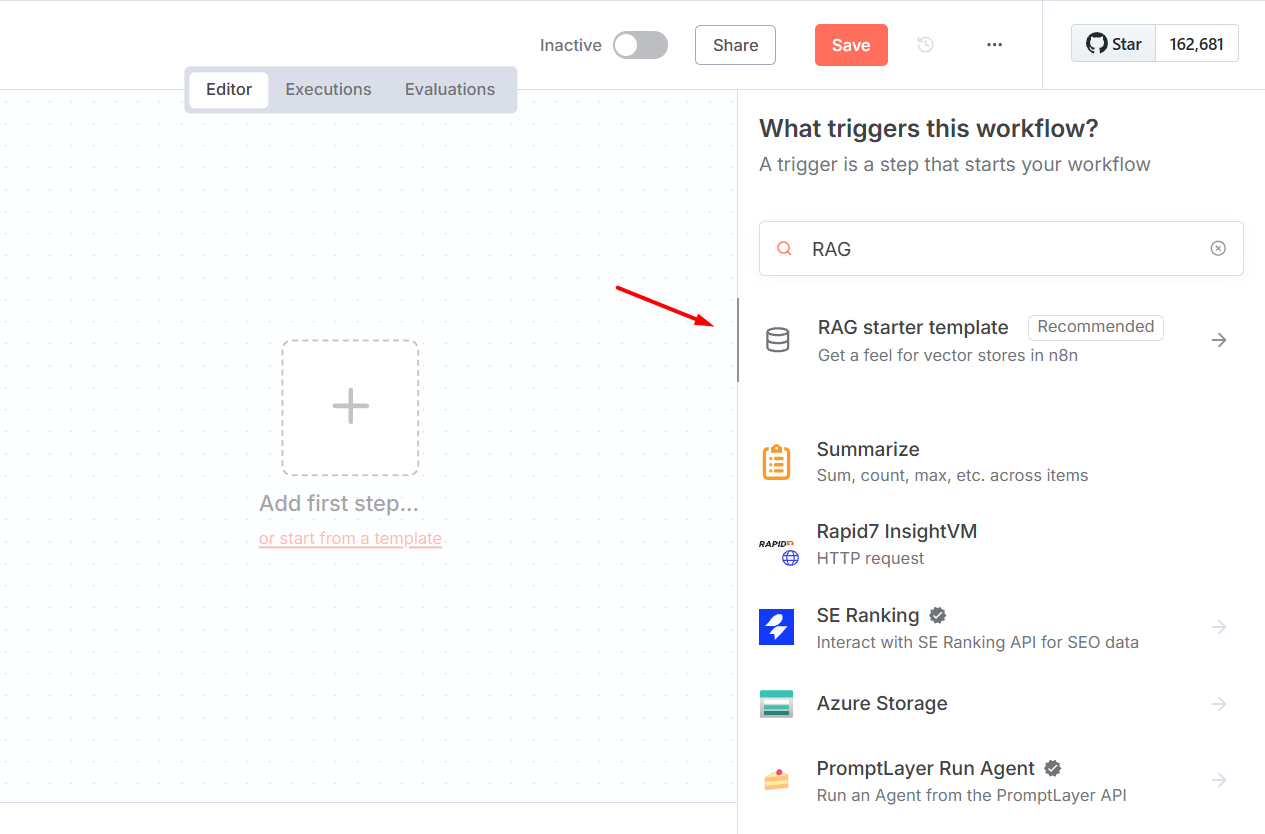
Bước 2: Chọn “RAG starter template”. Bạn sẽ được chuyển sang một tab mới với workflow đã được thiết lập sẵn các node cần thiết, giúp tiết kiệm thời gian thiết lập thủ công.

Giải thích chi tiết cấu trúc Workflow
Luồng nạp dữ liệu (Load Data Flow)
Luồng này thực hiện chức năng tiếp nhận tệp tin từ người dùng và lưu vào Simple Vector Store, kho vector nằm trong bộ nhớ của n8n.
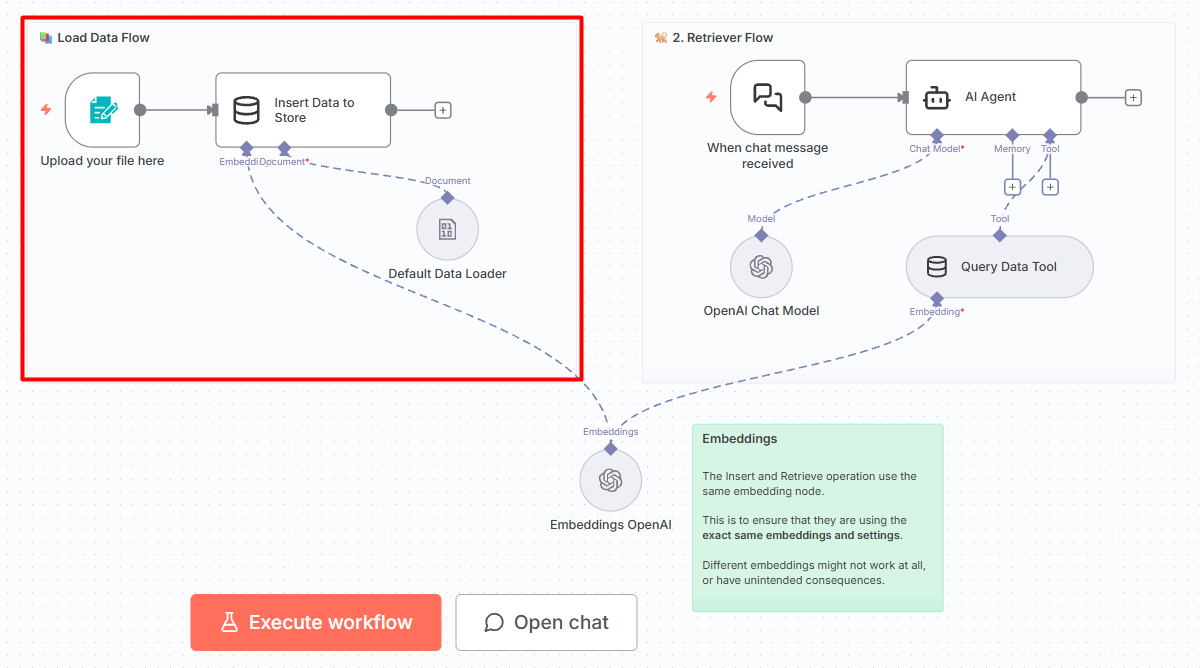
Node n8n Form Trigger:
Đây là cổng tiếp nhận dữ liệu đầu vào. Người dùng sẽ tải tệp tin (PDF, Docx, Text) lên thông qua một giao diện biểu mẫu web (Form). Tệp tin nhị phân sau đó được chuyển trực tiếp đến node xử lý tiếp theo.
Node Simple Vector Store:
Đây là node chính của luồng nạp dữ liệu.
- Chức năng: kho vector đơn giản lưu dữ liệu trong bộ nhớ của n8n. Theo tài liệu n8n, dữ liệu mất khi n8n khởi động lại và node chỉ nên dùng khi phát triển; chạy thật nên đổi sang vector database như Qdrant, Pinecone, Supabase.
- Cơ chế xử lý: node dùng một module gắn kèm là Default Data Loader ở cổng Document.
- Default Data Loader: nhận tệp từ Trigger, đọc và trích nội dung văn bản, chia đoạn rồi đưa vào Simple Vector Store để lưu.
Luồng truy xuất và hội thoại (Retriever Flow)
Luồng này đảm nhiệm việc tương tác với người dùng và trả lời câu hỏi dựa trên dữ liệu vừa nạp.
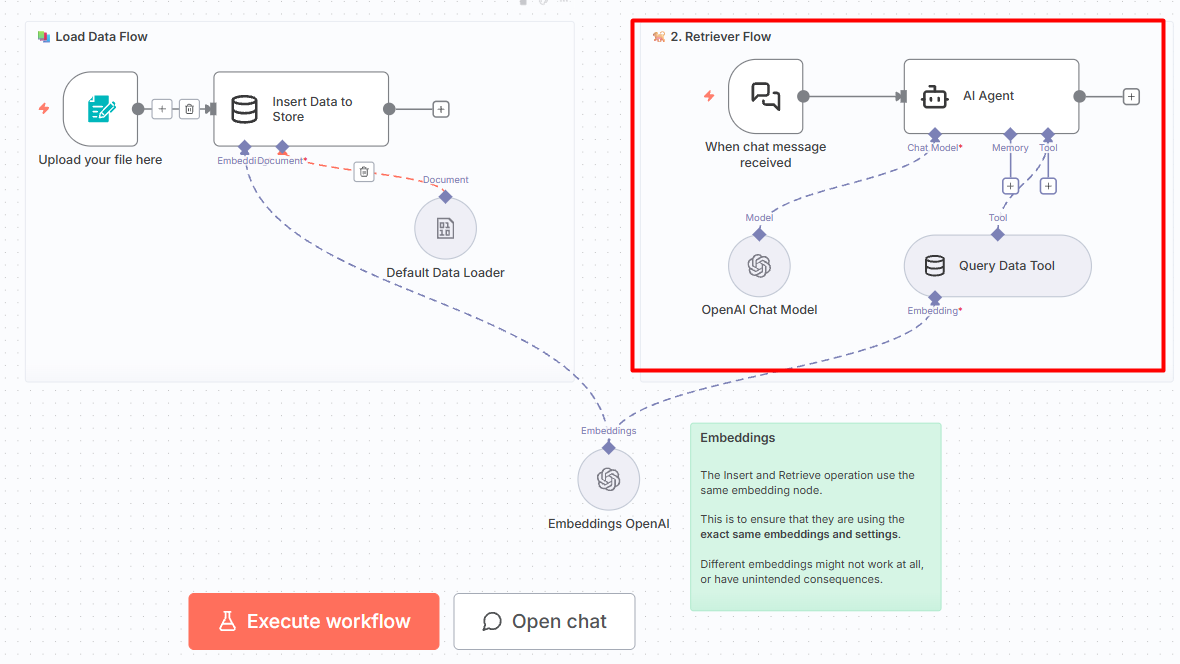
Node “When chat message received” (Chat Trigger):
Khởi động quy trình khi có tin nhắn mới từ giao diện chat (có thể thay thế tùy vào trường hợp sử dụng thực tế).
Node “AI Agent”:
Trung tâm điều khiển của Chatbot. Node này bao gồm OpenAI Chat Model và Simple Vector Store tool.
Khi AI Agent cần thông tin, tool này sẽ tìm kiếm các đoạn văn bản tương đồng trong bộ nhớ và trả về kết quả cho AI xử lý.
Thành phần cốt lõi dùng chung: Embeddings OpenAI
Đây là yếu tố kỹ thuật bắt buộc để hai luồng có thể “hiểu” nhau.
- Vị trí và kết nối: Node Embeddings OpenAI nằm ở phía dưới và kết nối vào cổng Embeddings của cả node Simple Vector Store bên Load Data Flow và Retriever Flow.
- Vai trò: Việc sử dụng chung một node đảm bảo rằng thuật toán mã hóa dữ liệu đầu vào và thuật toán mã hóa câu hỏi truy vấn là hoàn toàn giống nhau. Nếu sử dụng hai node Embeddings khác nhau, hệ thống sẽ không thể tìm thấy dữ liệu chính xác do sự sai lệch về không gian số học vector.

Bảo vệ API key: lưu key OpenAI trong mục Credentials của n8n, không dán vào node Code hay chia sẻ workflow kèm key; đặt giới hạn chi tiêu trong trang quản lý của OpenAI và tạo key mới ngay khi nghi lộ. Chi tiết ở bài bảo mật credentials và API key trong n8n.
Một số lưu ý để tối ưu hóa hiệu suất RAG trên n8n
Nối node xong mới là bước đầu. Chất lượng RAG phụ thuộc chủ yếu vào cách chia đoạn, độ sạch của tài liệu, chỉ dẫn cho agent và mô hình embedding; nên chuẩn bị một bộ câu hỏi mẫu có đáp án để thử lại mỗi khi thay đổi một trong bốn yếu tố này.
Chiến lược phân đoạn văn bản (Chunking Strategy)
Kích thước của các đoạn văn bản (Chunk size) ảnh hưởng trực tiếp đến chất lượng câu trả lời.
- Kích thước quá nhỏ: AI có thể mất ngữ cảnh cần thiết để hiểu trọn vẹn ý nghĩa.
- Kích thước quá lớn: Dữ liệu tìm được sẽ chứa nhiều thông tin nhiễu không liên quan, làm giảm độ chính xác của câu trả lời.
- Giải pháp: Trong n8n, Default Data Loader có các kiểu chia Character, Recursive Character và Token; tài liệu n8n khuyên dùng Recursive Character cho đa số trường hợp và đặt chunk overlap để giữ mạch giữa các đoạn. Thử vài kích thước với bộ câu hỏi mẫu rồi chọn mức cho kết quả ổn định.
Chất lượng dữ liệu đầu vào
Hệ thống RAG hoạt động theo nguyên tắc “Rác vào, rác ra” (Garbage In, Garbage Out). Trước khi nạp tài liệu vào node Simple Vector Store, hãy đảm bảo loại bỏ các thành phần không cần thiết như tiêu đề trang, số trang, header/footer lặp lại hoặc các ký tự đặc biệt gây nhiễu. Dữ liệu càng sạch, khả năng tìm kiếm của Vector Store càng chính xác.
Tối ưu hóa câu lệnh hệ thống
Trong node AI Agent, phần “System Message” đóng vai trò định hướng hành vi cho Chatbot. Hãy thiết lập một chỉ thị rõ ràng và nghiêm ngặt.
Ví dụ: “Bạn là trợ lý AI hữu ích. Chỉ được trả lời dựa trên thông tin ngữ cảnh được cung cấp. Nếu không tìm thấy thông tin trong tài liệu, hãy trả lời rằng tôi không biết, không được tự bịa ra thông tin.” Chỉ thị này giúp ngăn chặn hiện tượng ảo giác (hallucination) thường gặp ở các mô hình ngôn ngữ lớn.
Lựa chọn mô hình Embeddings phù hợp
Dù OpenAI Embeddings là lựa chọn phổ biến, nhưng đối với các tài liệu tiếng Việt chuyên ngành, người dùng có thể cân nhắc các mô hình khác hỗ trợ đa ngôn ngữ tốt hơn. Tuy nhiên, cần lưu ý nguyên tắc bất di bất dịch: Mô hình dùng để mã hóa khi nạp dữ liệu và mô hình dùng để truy vấn phải là một.
Ứng dụng thực tế của RAG với n8n
RAG hợp với mọi việc có dạng “hỏi đáp trên một kho tài liệu”: hướng dẫn sử dụng, quy trình nội bộ, hợp đồng, tin tức. Với n8n, bạn nối thêm kênh nhận câu hỏi (web chat, Slack, Microsoft Teams) và nguồn tài liệu (Google Drive, Notion) bằng các node có sẵn.
- Trợ lý ảo hỗ trợ khách hàng: Tự động trả lời các câu hỏi thường gặp dựa trên kho tài liệu hướng dẫn sử dụng, chính sách bảo hành hoặc catalog sản phẩm. Hệ thống này giúp giảm tải cho đội ngũ nhân sự và hoạt động liên tục 24/7.
- Hệ thống tra cứu quy trình nội bộ: Nhân viên mới thường mất nhiều thời gian để tìm hiểu quy định công ty. Một Chatbot RAG tích hợp trên Slack hoặc Microsoft Teams (qua n8n) có thể giúp nhân viên tra cứu nhanh thông tin về quy trình xin nghỉ phép, phúc lợi, hay quy định bảo mật chỉ trong vài giây.
- Phân tích hợp đồng và văn bản pháp lý: Nạp các tệp PDF hợp đồng dài hàng trăm trang vào hệ thống. Sau đó, người dùng có thể đặt các câu hỏi cụ thể như “Điều khoản phạt chậm thanh toán là bao nhiêu?” hoặc “Thời hạn hiệu lực của hợp đồng là khi nào?” để AI trích xuất thông tin chính xác.
- Tóm tắt và khai thác tin tức thị trường: Đọc nguồn tin được phép dùng (RSS, bản tin đã đăng ký) bằng node có sẵn, nạp vào vector store và yêu cầu AI tổng hợp xu hướng hằng ngày gửi về email.
Muốn chạy workflow RAG 24/7 mà không tự cài n8n? VPS n8n của Tino cài sẵn n8n trên VPS NVMe đặt tại Việt Nam. Xem cấu hình và giá trên trang sản phẩm. Nếu cần agent cá nhân thay vì workflow, xem chọn VPS chạy AI agent.
Câu hỏi thường gặp
Tôi có cần biết lập trình để xây dựng RAG trên n8n không?
Không nhất thiết. n8n cung cấp giao diện kéo thả trực quan và các mẫu (Template) có sẵn. Tuy nhiên, việc hiểu cơ bản về cấu trúc dữ liệu JSON sẽ giúp quá trình tùy chỉnh thuận lợi hơn.
Chi phí để vận hành hệ thống RAG này là bao nhiêu?
Chi phí chủ yếu đến từ API của nhà cung cấp model (embedding và chat, tính theo token) và nơi lưu vector database. n8n có bản Community tự host không thu phí bản quyền, nhưng bạn trả tiền máy chủ chạy nó.
Dữ liệu của tôi có được bảo mật không?
Khi tự host n8n, workflow, credential và kho vector nằm trên máy chủ của bạn. Các đoạn tài liệu được truy xuất vẫn được gửi tới nhà cung cấp model khi trả lời, nên cần đọc chính sách dữ liệu API hiện hành của nhà cung cấp đó hoặc dùng model chạy nội bộ với dữ liệu nhạy cảm.
Tại sao Chatbot trả lời sai hoặc không tìm thấy thông tin?
Nguyên nhân thường do cách chia đoạn chưa hợp lý, dữ liệu đầu vào nhiễu, hoặc luồng nạp và luồng hỏi dùng hai mô hình embedding khác nhau. Hãy kiểm tra lại từng yếu tố với một bộ câu hỏi mẫu.
Tôi có thể sử dụng các mô hình AI miễn phí (Local LLM) không?
Có. n8n có node Ollama cho chat model và embedding, nên bạn có thể chạy model mở trên máy chủ của mình; chất lượng và tốc độ phụ thuộc phần cứng. Xem local model là gì và Ollama là gì.
Hệ thống có hỗ trợ tiếng Việt tốt không?
Có thể dùng tốt với tiếng Việt, nhưng chất lượng phụ thuộc vào mô hình embedding và chat model. Nên thử vài mô hình embedding đa ngôn ngữ với bộ câu hỏi tiếng Việt của chính bạn trước khi chọn.